Исследования
Rapidata предложила заменить модель-судью настоящими человеческими оценками в цикле обучения диффузионных моделей
2 октября 2026 года компания Rapidata опубликовала на Hugging Face технический разбор о том, как встроить настоящие человеческие предпочтения в цикл пост-обучения визуальных генеративных моделей вместо обученной модели-судьи (reward model). Механизм опирается на продукт Rapidata Flows: аннотаторы попарно сравнивают группы изображений, модель Брэдли–Терри превращает голоса в Elo-оценки, а те подаются в обучение как сигнал награды. Для конфигурации Flow-GRPO на 24 GPU A800 авторы насчитали потребность примерно в 2 400 ответах в минуту и утверждают, что их система это выдерживает.
Зачем вообще нужна человеческая обратная связь
Выравнивание по человеческим предпочтениям — ключевой шаг обучения большинства визуальных генеративных моделей: изображений, видео и, всё чаще, мировых моделей. Без него результаты обычно менее приятные, менее естественные и менее связные.
Существующие подходы к такому выравниванию идут на один из двух компромиссов. Методы прямой оптимизации по человеческим предпочтениям, например Diffusion-DPO, собирают предпочтения заранее, до начала оптимизации, поэтому распределение обратной связи остаётся фиксированным, пока политика меняется. Онлайн-методы — скажем, Flow-GRPO — получают новые оценки на свежих генерациях прямо во время обучения и, по измерениям авторов, обходят офлайн-варианты и онлайн-версии DPO.
Но и онлайн-подход обычно опирается на обученную модель-судью, такую как PickScore или ImageReward. Такой суррогат может расходиться с человеческим суждением, особенно когда распределение выходов уходит от данных, на которых судью обучали, и его можно эксплуатировать в ходе оптимизации: получать изображения с артефактами, которые всё равно набирают высокий балл, или терять визуальное разнообразие.
Что предлагает Rapidata
Очевидное решение — собирать настоящую человеческую обратную связь прямо во время обучения и использовать её как обучающий сигнал. Главным препятствием становятся скорость и задержка: данных нужно много и очень быстро, иначе вычислительные ресурсы простаивают.
Rapidata даёт программный доступ к большой аудитории аннотаторов для коротких задач, что подходит для проверки визуальных генераций и сбора предпочтений. Функция, построенная именно для обратной связи в реальном времени в онлайн-RLHF, называется Flows.
Механика такая: ранжирование группы изображений разбивается на попарные сравнения, а голоса объединяются в итоговые оценки по модели Брэдли–Терри. В результате каждое изображение в группе получает Elo-подобный балл, который напрямую превращается в величины преимуществ (advantages).
Как это встаёт в цикл Flow-GRPO
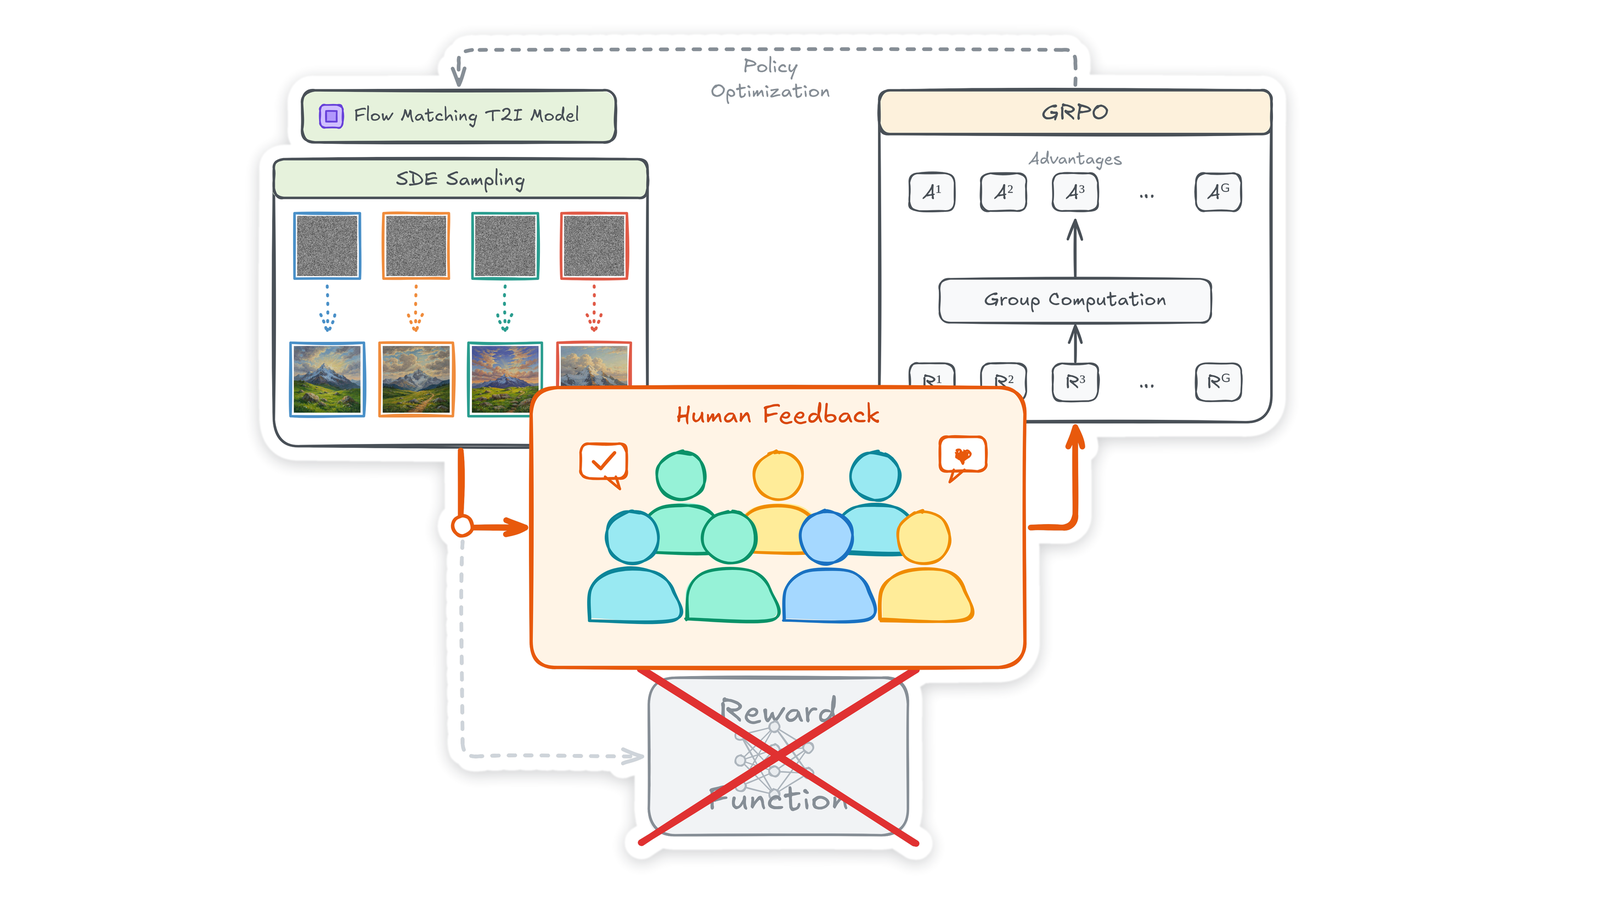
Схема цикла: модель генерирует группы изображений на один и тот же промпт; каждая группа параллельно уходит в свой Flow; аннотаторы сравнивают картинки попарно по заданной инструкции; модель Брэдли–Терри превращает голоса в балл для каждого изображения, и эти баллы возвращаются в обучение как сигнал. На втором шаге обновления — там, где обычно оценивает модель-судья, — API Rapidata просто встаёт на её место, всё остальное можно оставить как есть.
Минимальный код из публикации: создаётся клиент RapidataClient(), затем поток ранжирования client.flow.create_ranking_flow(name=..., instruction=...); сам Flow переиспользуется во всём прогоне обучения.
Группа изображений отправляется вызовом flow.create_new_flow_batch(datapoints=[...], time_to_live=180), где datapoints — это картинки по URL или локальным путям, а time_to_live задаёт окно ожидания в секундах. Результаты забирает flow_item.get_results(), который блокируется до полноты группы или до истечения времени, а results.datapoints сопоставляет каждое изображение с его баллом.
Дальше оценки нормируются в преимущества ровно так же, как Flow-GRPO это делает с выходами модели-судьи: advantages = (rewards - rewards.mean()) / (rewards.std() + 1e-8). Поскольку баллы нормируются внутри каждой группы, абсолютная шкала Elo не важна.
Авторы отдельно отмечают асинхронность: потенциально сотни групп оцениваются параллельно, поэтому выставление оценок может начаться ещё до того, как сгенерированы все изображения батча. Именно это и позволяет сократить простой GPU во время сбора оценок.
Пропускная способность: 2 400 ответов в минуту
Отдельная часть разбора — арифметика нагрузки. Согласно публикации, Flow-GRPO обучается на 24 GPU A800 и за раунд генерирует 48 групп по 24 изображения, то есть 48 Flow-элементов на шаг обучения. По опыту авторов, для групп из 24 изображений разумно 100–150 ответов на группу.
При дедлайне в 3 минуты, который авторы считают реалистичным с учётом прямого и обратного проходов, получается 48 × 150 / 3, то есть 2 400 ответов в минуту. По утверждению Rapidata, их система это легко выдерживает; нагрузку можно и разнести, например тремя батчами по 16 групп за минуту.
Дополнительные рекомендации из публикации — обучать LoRA вместо всей модели и сдвинуть человеческую оценку на один шаг назад, чтобы отзывы по одному батчу собирались, пока генерируется следующий.
Распределённое обучение и рамки Flows
При сотнях и тысячах GPU-воркеров, одновременно обращающихся к Flow, отдельная аутентификация каждого может вызвать шквал одновременных обновлений токена и рейт-лимит. Поэтому авторы советуют аутентифицироваться один раз в процессе-координаторе, например на rank 0, и раздать токен: координатор вызывает maintain_token_file(path), а воркеры — RapidataClient(token_file=path). Файл токена нужно ограничить по правам и держать вне системы контроля версий и логов.
Официальная документация уточняет рамки самой функции: Flow создаётся один раз с инструкцией и настройками оценки и переиспользуется для новых батчей; поддерживаются изображения, видео, аудио и текст. У каждого батча есть лимит времени time_to_live — до одного часа, по умолчанию 4 минуты; когда время вышло, можно забрать уже собранные ответы.
Что здесь факт, а что утверждение вендора
Публикация Rapidata — это не релиз модели, а описание продуктового механизма: компания продаёт доступ к аннотаторам и предлагает заменить суррогатную награду живыми оценками, не перестраивая остальной цикл обучения.
Сравнительных метрик качества моделей, обученных по этой схеме, в посте нет: там есть описание алгоритма, минимальный код и расчёт пропускной способности. Разбор сопровождается двумя иллюстрациями — сравнением «до и после» выравнивания по человеческим предпочтениям и схемой места Flows в цикле Flow-GRPO.
Авторы приглашают писать на info@rapidata.ai и напоминают про исследовательские гранты, покрывающие до $50 000 в кредитах на аннотации для одного проекта, с приоритетом тем, близких к их собственным, — таких как онлайн-RLHF.