Исследования
«Поддерживается где-то — не то же самое, что поддерживается правильным источником»: ProvenanceGuard проверяет не только факт, но и то, из какого источника он взят
29 сентября 2026 года команда Multiverse Computing опубликовала в блоге Hugging Face разбор ProvenanceGuard — пост-генерационного слоя проверки, который сохраняет идентичность источника на каждой претензии агента, работающего через Model Context Protocol. На отложенной выборке из 40 трасс система даёт block F1 0,802 и точность выбора источника 0,858 по 260 претензиям с определяемым источником, тогда как baseline-проверки источник не называют вовсе. Эксперты отметили 139 претензий как недопустимые, и система поймала 138 из них, а на более сложном наборе с похожими источниками точный источник определяется лишь в 50,3% случаев.
Что произошло
Пост вышел 29 сентября 2026 года, под ним подписаны Antonio Tiene, Ander Alvarez Sanz и Oliver Wirjadi из Multiverse Computing. Он представляет статью «ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents»: её версия на arXiv впервые отправлена 16 июня 2026 года и последний раз пересмотрена 27 августа 2026 года (v3), авторы — Ander Alvarez, Santhiya Rajan, Alessandro Genuardi, Oliver Wirjadi, Samuel Mugel и Román Orús, а страница статьи на Hugging Face Papers датирована 27 августа. Содержательно это пост-генерационный слой проверки, который ставится поверх чёрноящичного MCP-агента и работает уже после того, как агент выдал ответ.
Отправная точка — смена режима работы агентов: агент с инструментами давно не читает один найденный фрагмент, а через Model Context Protocol вызывает поиск, заглядывает в структурированную запись пациента или клиента, обращается к базе данных и подтягивает метаданные, после чего сводит всё это в один ответ. Из этого авторы выводят отдельный тип ошибки, который называют cross-source conflation: утверждение истинно где-то в собранных доказательствах, но приписано не тому источнику.
Поддержка без источника
Обычные системы проверки — от RAGAS faithfulness до точечных проверяльщиков вроде MiniCheck, AlignScore и SummaC — спрашивают, подтверждается ли утверждение доступными доказательствами, но сами доказательства при этом уже сведены в один общий пул. В такой форме они не сообщают, какой именно вывод инструмента поддерживает конкретное утверждение и совпадает ли он с тем источником, который назван в ответе.
Пример, который авторы разбирают прямым текстом: агент поддержки отвечает «согласно записи аккаунта, этот тариф включает 30-дневное окно возврата». Окно возврата может быть совершенно реальным, но сказано о нём в документе политики, а не в записи аккаунта, на которую ссылается ответ. Стоит свести оба источника в один пул — и утверждение выглядит подтверждённым; стоит держать их раздельно — и атрибуция оказывается неверной. В чувствительных к данным сценариях неверная атрибуция может вредить не меньше неверного факта, поэтому авторы отдельно оговаривают, что для MCP-агентов одних оценок верности (faithfulness) недостаточно: ответ несёт происхождение высказывания, иногда явно («согласно записи аккаунта»), иногда неявно.
Как устроена проверка
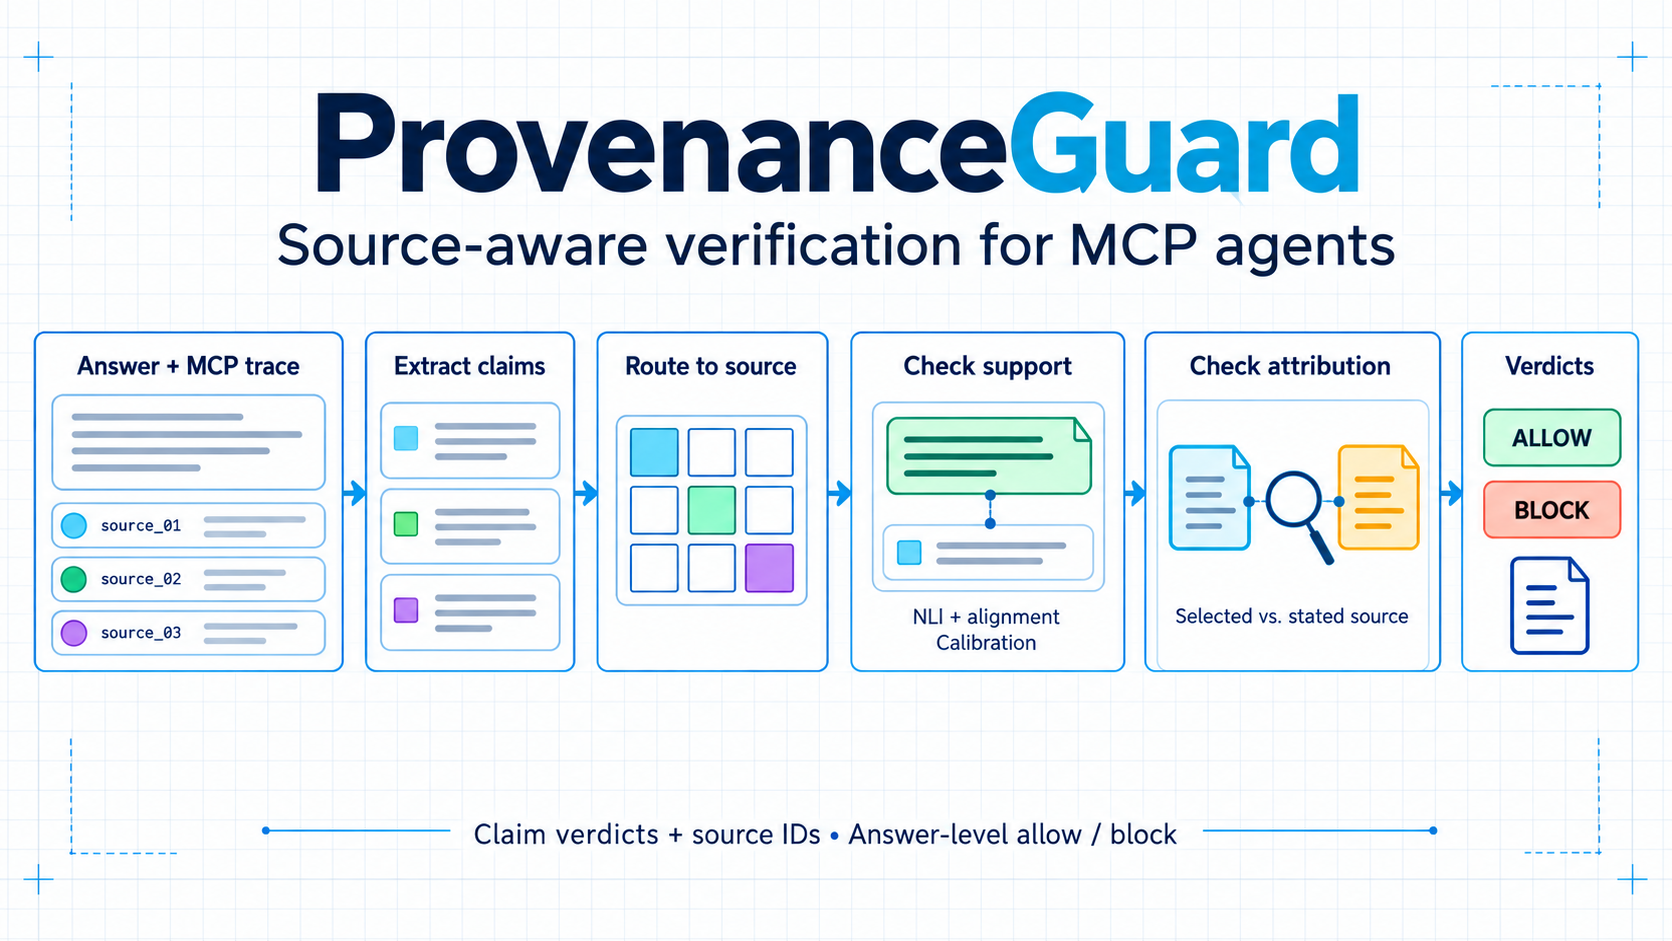
ProvenanceGuard читает записанную трассу MCP со стабильными идентификаторами инструментов, идентификаторами источников и сырыми выводами — переобучать агента для этого не нужно. Слой никогда не сворачивает доказательства в один анонимный контекст, а проносит идентичность источника через весь конвейер и делает пять шагов последовательно: разбивает ответ на отдельные утверждения, находит наиболее релевантный источник для каждого, проверяет, действительно ли этот источник его поддерживает, сравнивает источник с тем, который ответ называет или подразумевает, и выдаёт вердикт по каждому утверждению вместе с решением на уровне всего ответа — пропустить или заблокировать.
Отдельная деталь — проверка буквальных значений: число, дата или идентификатор, которых нет в источнике, не могут пройти только потому, что предложение звучит правдоподобно, а калиброванный шаг решения сводит сигналы вместе. Заблокированный ответ не остаётся тупиком: его можно провести через ремонт в стиле RARR — пересборку, опирающуюся на источник, или безопасный фолбэк, — и затем проверить заново.
В описанных экспериментах использовались локальные модели: MiniLM помогает выбрать источник, DeBERTa-NLI проверяет поддержку утверждения, локальная языковая модель разбивает ответ на утверждения. Авторы подчёркивают, что названные модели — это измеренная конфигурация, а не требование метода: те же шаги можно перенести на облачные модели, но новая связка потребует собственного тестирования и калибровки, а все приведённые результаты относятся именно к локальной конфигурации.
Что показали измерения
Проверка шла на ответах медицинского агента, который пользовался записями пациентов, научными статьями и другими инструментами: так набралось 281 реальная трасса. Из них выделен проверенный вручную набор из 266 трасс, давший 2 325 разметок утверждений, распределённых по трассам, а 361 разметка из отложенной части проверена людьми. На отложенной выборке из 40 трасс система показала block F1 0,802 и точность выбора источника 0,858 по 260 утверждениям с определяемым источником.
Самая наглядная формулировка результата — в блоге: эксперты сказали, что 139 утверждений проходить не должны, и ProvenanceGuard поймал 138 из них, пропустив одно. Кроме того, система придержала 67 утверждений, которые эксперты считали подтверждёнными, и отправила их на проверку или ремонт — измеренная настройка сознательно осторожная, она предпочитает лишний взгляд на подтверждённое утверждение пропуску неподтверждённого. На том же отложенном наборе система сравнивалась с четырьмя обычными проверяльщиками по метрике отсечения: MiniCheck — 0,783, RAGAS Faithfulness — 0,758, AlignScore — 0,662, SummaC-ZS — 0,436, и ни один из них не выдаёт связку «утверждение — источник».
На отдельном, более сложном наборе с несколькими похожими источниками отсечение остаётся высоким (block F1 0,846), но точный источник определяется лишь в 50,3% случаев, а в терминах статьи точность пары «источник и отношение» падает до 0,229. Зато в контролируемой пробе на неверную атрибуцию — названный источник подменили в 50 случаях, оставив подтверждающие доказательства нетронутыми, — пойманы все 50 подмен. Ремонт тоже измерили: в полном прогоне он разрешил все 173 заблокированных ответа, правда 144 из них закончились фолбэком, а не содержательной перепиской; на восстановленных многоисточниковых трассах свежий прогон ремонта разрешил все 59 изначально заблокированных ответов при двух терминальных фолбэках. Накладные расходы в локальной конфигурации описаны как скромные — примерно полсекунды на ответ.
Границы и контекст
Различать похожие источники авторы называют важным направлением для улучшения — отсюда и 50,3% точного источника на сложном наборе. Второе ограничение — конфигурация: результаты получены на локальных моделях и офлайн-обработке трасс, а облачная связка потребует своей калибровки. Третье — осторожность решения: вариант, который придерживает часть подтверждённых утверждений, подходит для чувствительного к данным разбора, где правильный источник важнее самой быстрой выдачи.
Есть и внешнее подтверждение подхода: NVIDIA встроила в NVFlow дополнительный этап проверки обоснованности для своего финансового агента — он сверяет готовые ответы с фрагментами SEC, которые агент извлёк, и сохраняет отдельные решения, не меняя исходный прогон и обучающие данные; в блоге сказано, что вклад NVFlow опирается на подход source-aware-проверки ProvenanceGuard, тогда как цикл ремонта относится к более широкой исследовательской системе. Работа также была представлена как постер на Agentic AI Summit 2026 в UC Berkeley. Вывод авторов статьи звучит так: атрибуция источника — независимая ось проверки фактичности в агентах на MCP.
Первоисточники
- Hugging Face Blog — Antonio Tiene, Ander Alvarez Sanz, Oliver Wirjadi (Multiverse Computing), «Getting the Source Right, Not Just the Fact: Source-Aware Verification for MCP Agents» (29 сентября 2026)
- arXiv:2606.18037 — Ander Alvarez, Santhiya Rajan, Alessandro Genuardi, Oliver Wirjadi, Samuel Mugel, Román Orús, «ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents» (v1 16 июня 2026, v3 27 августа 2026)
- Hugging Face Papers — ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents (страница статьи, arXiv:2606.18037)