Исследования
Perplexity открыла Q2D-Web — бенчмарк первого этапа поиска для агентных RAG-систем
190 млн веб-документов, 69 721 переформулированный агентом запрос на десяти языках и три независимых набора оценок релевантности: Perplexity описала, почему полный прогон одного ретривера стоит тысячи часов на H200 и как субсэмплинг возвращает оценку к трети стоимости.
Что выложила Perplexity
9 сентября 2026 года команда Perplexity Engineering представила Q2D-Web (Query2Doc-Web) — закрытый бенчмарк и публичный лидерборд для оценки первого этапа поиска в агентных RAG-системах. Бенчмарк продолжает исходный Q2D, расширяя корпус, увеличивая число запросов и углубляя разметку релевантности.
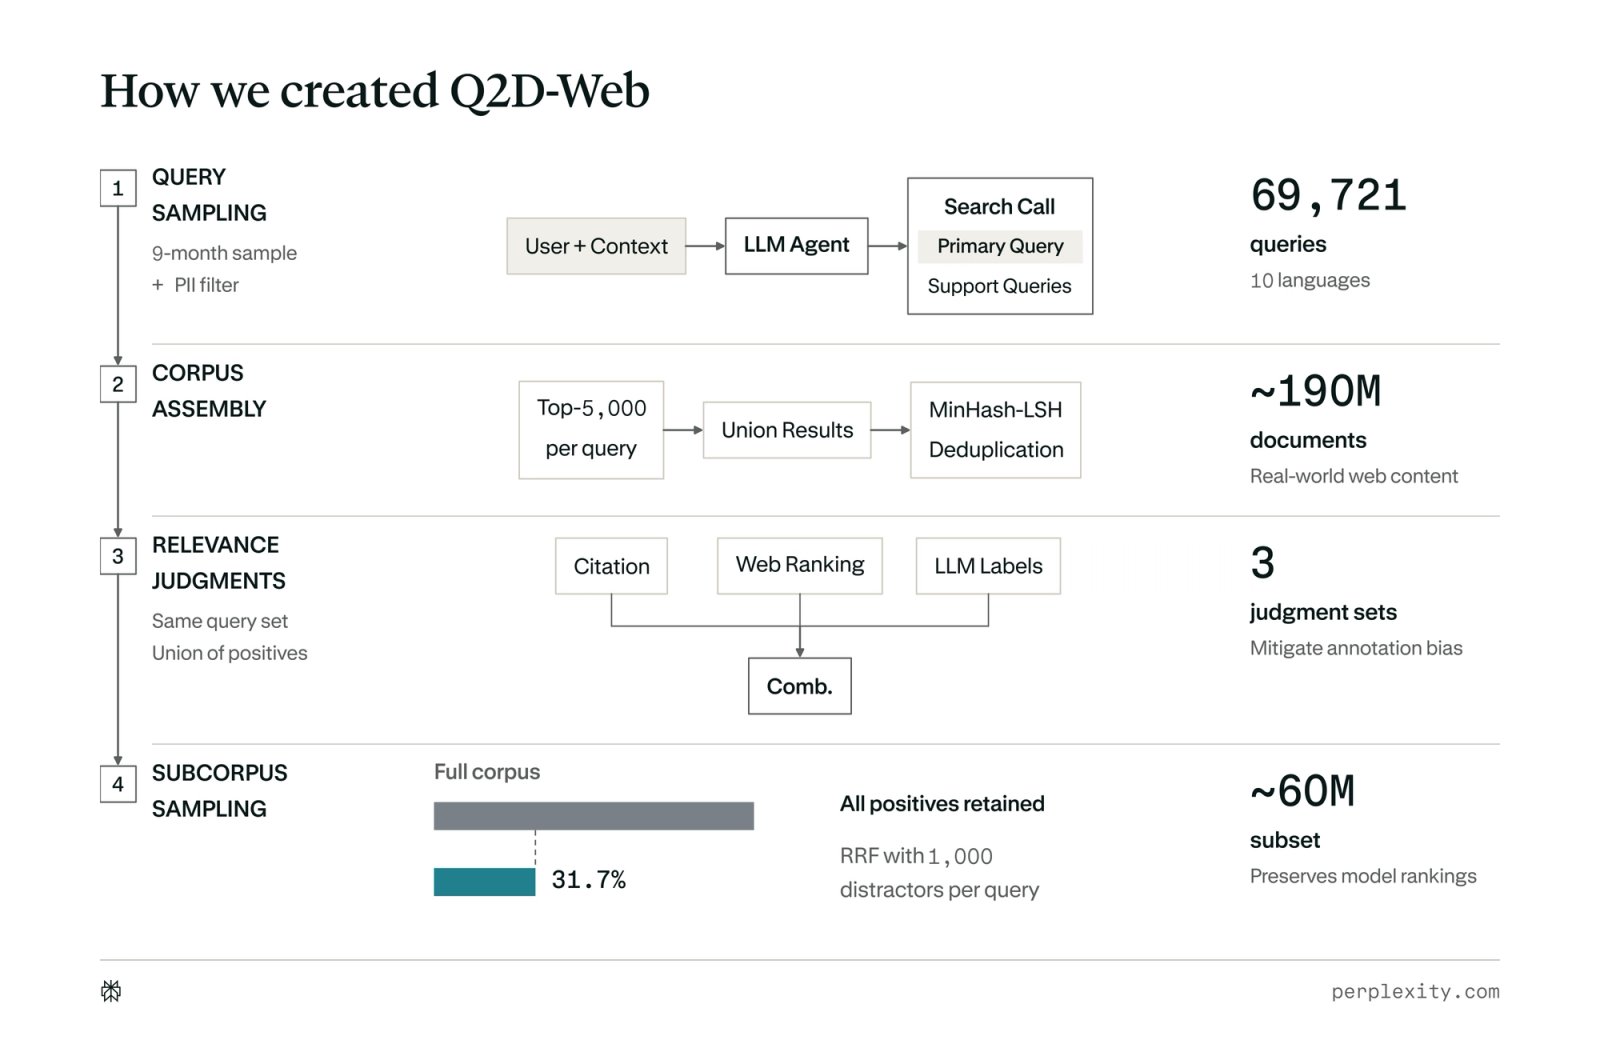
Внутри — 190 млн веб-документов и 69 721 запрос, переформулированный агентами, на десяти языках; данные собраны за девять месяцев продакшен-трафика поиска, уже очищенного от персональной информации. Описание бенчмарка отдельно опубликовано на arXiv 8 сентября 2026 года.
Среднее число положительных оценок релевантности на запрос в объединённом наборе — 99,6. Ближайшее публичное сравнение авторы видят в MS MARCO Web Search: 100,9 млн документов, 9 374 тестовых запроса и одна положительная метка на запрос, выведенная из кликов.
Откуда берутся запросы
Основой стали 23 000 продакшен-поисков на десяти языках и в десятках доменов, собранных за девять месяцев. Поиск здесь — это все вызовы инструмента веб-поиска, которые агент делает в ответ на сообщение пользователя: в каждом вызове один или несколько запросов, переформулированных из запроса пользователя, предыдущей переписки и уже найденных документов.
В каждом поиске есть основной запрос, повторяющий информационную потребность пользователя, и вспомогательные, которые пробуют другие формулировки, фон или связанные сущности; каждый запрос оценивается отдельно, со своей разметкой.
Приватность фильтруется жёстко: берутся только запросы пользователей, разрешивших использование данных, а детектор perplexity-ai/pplx-pii-masking отсеивает запросы с персональной информацией. Точные дубликаты, очень короткие запросы и запросы с операторами вида site: или кавычками удаляются. Английский занимает 65,8% запросов, дальше идут испанский, русский, немецкий, французский, португальский, итальянский, корейский, японский и китайский.
Корпус и три набора оценок
Корпус собран так: для каждого запроса продакшен-система достаёт топ-5000 документов, наборы результатов объединяются и дедуплицируются через MinHash–LSH — в один кластер попадают документы, у которых Jaccard-сходство наборов токенных 5-грамм не ниже 0,975. Это намеренно не случайная выборка веба: каждый документ был правдоподобным результатом хотя бы для одного запроса, что создаёт плотный набор сложных отвлекающих страниц.
Разметка разделена на три набора. Citation помечает документ релевантным, если агент сослался на него в ответе: это ближайший к реальному использованию сигнал, но по построению с высокой точностью и низкой полнотой. Web Ranking содержит до 50 документов на запрос, в среднем 43,1, найденных внутренним стеком — BM25 и плотный поиск на первом этапе, затем кросс-энкодерный реранкинг.
Combined + LLM-Judged объединяет Citation и Web Ranking и добавляет оценки языковой модели для ранее не размеченных кандидатов: результаты BM25, ColBERTv2 и семи плотных ретриверов, вышедших до 1 января 2025 года, сливаются через reciprocal rank fusion, после чего топ-500 неразмеченных документов оценивает DeepSeek-V4-Flash со строгим бинарным судейством.
Субсэмплинг и цена оценки
Полный прогон по всему корпусу дорог: одна оценка с pplx-embed-v1-4b требует 4 608 GPU-часов на H200, а даже небольшая EmbeddingGemma-300M — почти 200 часов. Поэтому авторы собрали субкорпус: стратегия на основе reciprocal rank fusion использует 31,7% документов полного корпуса, сохраняет порядок моделей и завышает средний Recall@1000 лишь на 4,5 пункта против 11,1 пункта у случайной выборки того же размера.
На таком субкорпусе pplx-embed-v1-4b укладывается примерно в 1 500 часов на H200, а EmbeddingGemma-300M — меньше чем в 70. Каждую заявку сначала оценивают на выборке; модели делят на две группы по числу параметров — до 1 млрд и больше 1 млрд, — и только попавшие в топ-10 своей группы уходят на полный корпус.
Что показывают результаты
Основная метрика — Recall@1000: первый этап поиска должен лишь положить релевантные документы в пул кандидатов, а финальный порядок определяет реранкер. В работе на arXiv авторы сообщают, что прогнали 13 ретриверов, включая лексические, плотные и модели с поздним взаимодействием.
Их взаимный порядок почти не зависит от выбора набора оценок, но заметно расходится по тематическим доменам, языкам запросов и типам запросов. Отдельная оговорка: модели Perplexity оцениваются тем же пайплайном, что и остальные, однако бенчмарк построен на продакшен-трафике Perplexity, поэтому у них может быть преимущество «в распределении».
Лидерборд публикует результаты открытых моделей, заявку можно отправить через форму, а модель должна быть публично доступна на Hugging Face вместе с полным описанием воспроизводимой схемы поиска.