Исследования
Perplexity выпустила PII-Tracer — локальный детектор персональных данных на 0,6 млрд параметров
Новый benchmark PII-TRACE проверяет, замечает ли detector каждое повторение идентификатора в длинном диалоге. Компактный PII-Tracer лидирует в тесте по character F1 и может работать до отправки текста в cloud.
Приватность проверяется не по одному сообщению
Perplexity представила PII-TRACE — benchmark для проверки детекторов personally identifiable information в длинных многоходовых диалогах — и PII-Tracer, компактную модель на 0,6 млрд параметров. Их задача состоит не в генерации ответа, а в поиске точных участков текста, которые нельзя незаметно передавать из локальной среды в cloud.
Для hybrid AI эта граница критична: research и reasoning могут выполняться удалёнными frontier models, тогда как файлы и sensitive context остаются на устройстве. Local privacy gate должен распознать персональные данные до сетевого запроса, после чего приложение решает, оставить ли ввод локально, скрыть найденные spans или запросить явное разрешение пользователя.
Обычная проверка отдельной записи здесь недостаточна. Имя может обозначать самого пользователя, публичную фигуру или вымышленный пример, а один телефон или адрес может повторяться в разных репликах. Если detector пропустит хотя бы одно повторение, высокая средняя полнота не предотвратит утечку конкретного идентификатора.
PII-TRACE измеряет последовательность, контекст и длину
Benchmark содержит 13 148 синтетических диалогов на 13 языках и в 10 системах письма. В них размечено 37 431 упоминание девяти типов PII на уровне символов; 41% разговоров включает structured content. Среди 5 645 диалогов с размеченными данными у 63,8% идентификатор встречается повторно, а у 28,7% проходит через несколько turns.
Набор оценивает два слоя качества. Character precision, recall и F1 показывают точность разметки текста, а consistent detection задаёт более строгий вопрос: найдены ли все символы во всех упоминаниях одного идентификатора. Отдельно учитываются повторения внутри разговора и случаи, когда одна сущность возвращается в разных репликах.
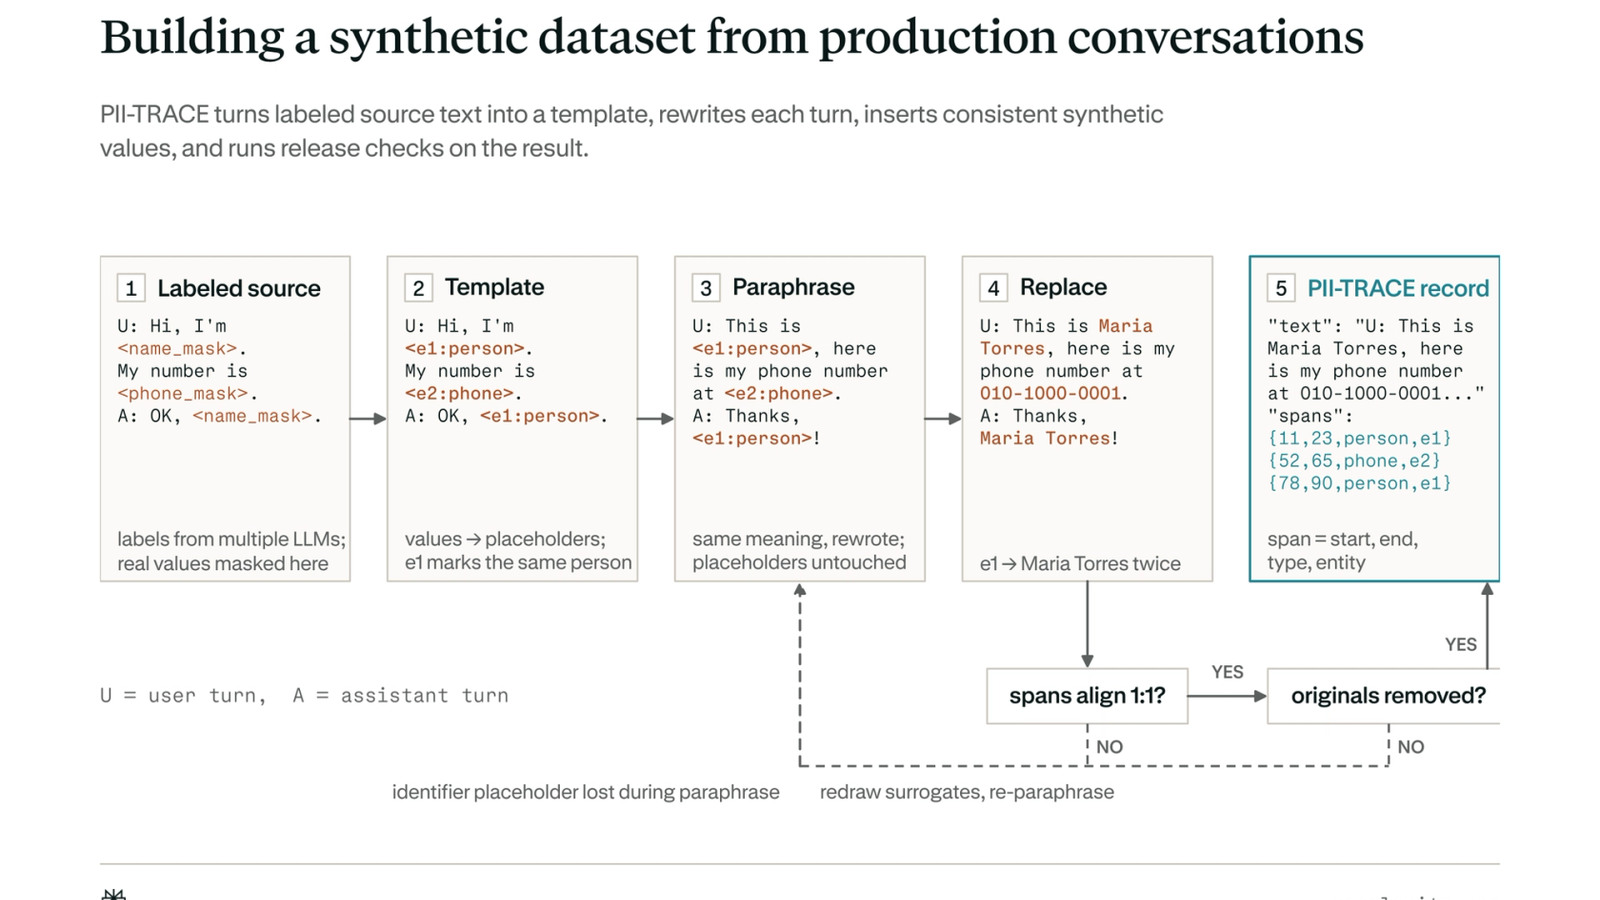
Исходные production conversations не публикуются. Pipeline размечает девять типов PII, связывает повторения через entity ID, заменяет значения typed placeholders, перефразирует реплики и подставляет синтетические идентификаторы с сохранением формата. Автоматические проверки ищут остатки исходных значений, ошибки offsets и несогласованные повторы; не прошедшие проверки записи пересоздаются или удаляются.
Qwen3 превратили из генератора в двунаправленный encoder
PII-Tracer адаптирован из Qwen3, но вместо causal mask использует padding-aware bidirectional attention: каждый token может учитывать и предыдущие, и последующие turns в окне 4 096 tokens. Это соответствует задаче span detection, где значение строки определяется окружающим контекстом, а не только последовательным предсказанием следующего token.
Encoder формирует 1 024-мерное представление каждого token. Linear tagging head выбирает среди 37 labels: одного класса для текста вне PII и четырёх BIOES-позиций для каждого из девяти типов. Вспомогательная head определяет наличие sensitive material на уровне всего разговора, включая сведения о здоровье или религии.
Модель обучали три эпохи примерно на 714 тысячах samples из multilingual assistant conversations и одиночных записей. При inference constrained Viterbi decoder ищет допустимую последовательность BIOES labels и возвращает точные character spans, которые приложение может локально скрыть или использовать как сигнал для routing.
Лидерство в тесте не отменяет проблему длинного контекста
Среди 12 проверенных систем PII-Tracer получил лучший character F1 — 0,629 — и второй результат по span-overlap и span-containment F1. Perplexity подчёркивает, что сопоставимые frontier models работают в cloud и значительно крупнее, тогда как PII-Tracer рассчитан на обработку непроверенного текста непосредственно на устройстве.
На строгой метрике модель нашла каждое упоминание у 79,4% повторяющихся идентификаторов и у 77,6% идентификаторов, переходящих между turns. При росте числа повторений результат снижался: от 0,917 для одного упоминания до 0,691 для группы с шестью–десятью. Это сильнее выбранных baselines, но всё ещё означает, что защита не является безошибочной.
Ограничение одного окна особенно заметно на длинных разговорах: recall составлял 0,975 ниже 1 000 символов и падал до 0,687 для диалогов от 10 000 символов. Sliding-window decoding с перекрытием 50% поднял общий character recall с 0,830 до 0,965 и consistent detection повторов с 0,794 до 0,954 без переобучения модели.
Reference model доступна, benchmark обещан позже
Perplexity опубликовала PII-Tracer на Hugging Face и приложила technical report, но сам PII-TRACE на момент announcement только планировалось выпустить. Поэтому исследователи могут изучить модель и описанную методику, однако полное независимое воспроизведение именно нового benchmark зависит от будущего доступа к набору.
В шести подробно показанных языках модель лидировала по character F1 для немецкого, французского, итальянского и русского и оставалась близка к лучшим результатам для английского и корейского. На пяти внешних benchmark PII-Tracer также превысил сравниваемый OpenAI Privacy Filter по character F1, хотя четыре из этих наборов не основаны на реальном human-labeled тексте.
Практический вывод — использовать detector как один контролирующий сигнал, а не как обещание абсолютной приватности. Routing policy, masking, consent и audit должны учитывать остаточный риск false negatives, особенно в длинных сессиях. PII-TRACE делает этот риск измеримым на уровне повторяющегося идентификатора — именно там, где усреднённая метрика отдельного сообщения может создавать ложное чувство защиты.