Исследования
«У нас недостаточно данных для индийских языков»: NVIDIA, IIT Madras и AI4Bharat выпустили корпус на 2,8 трлн токенов и открытый конвейер генерации
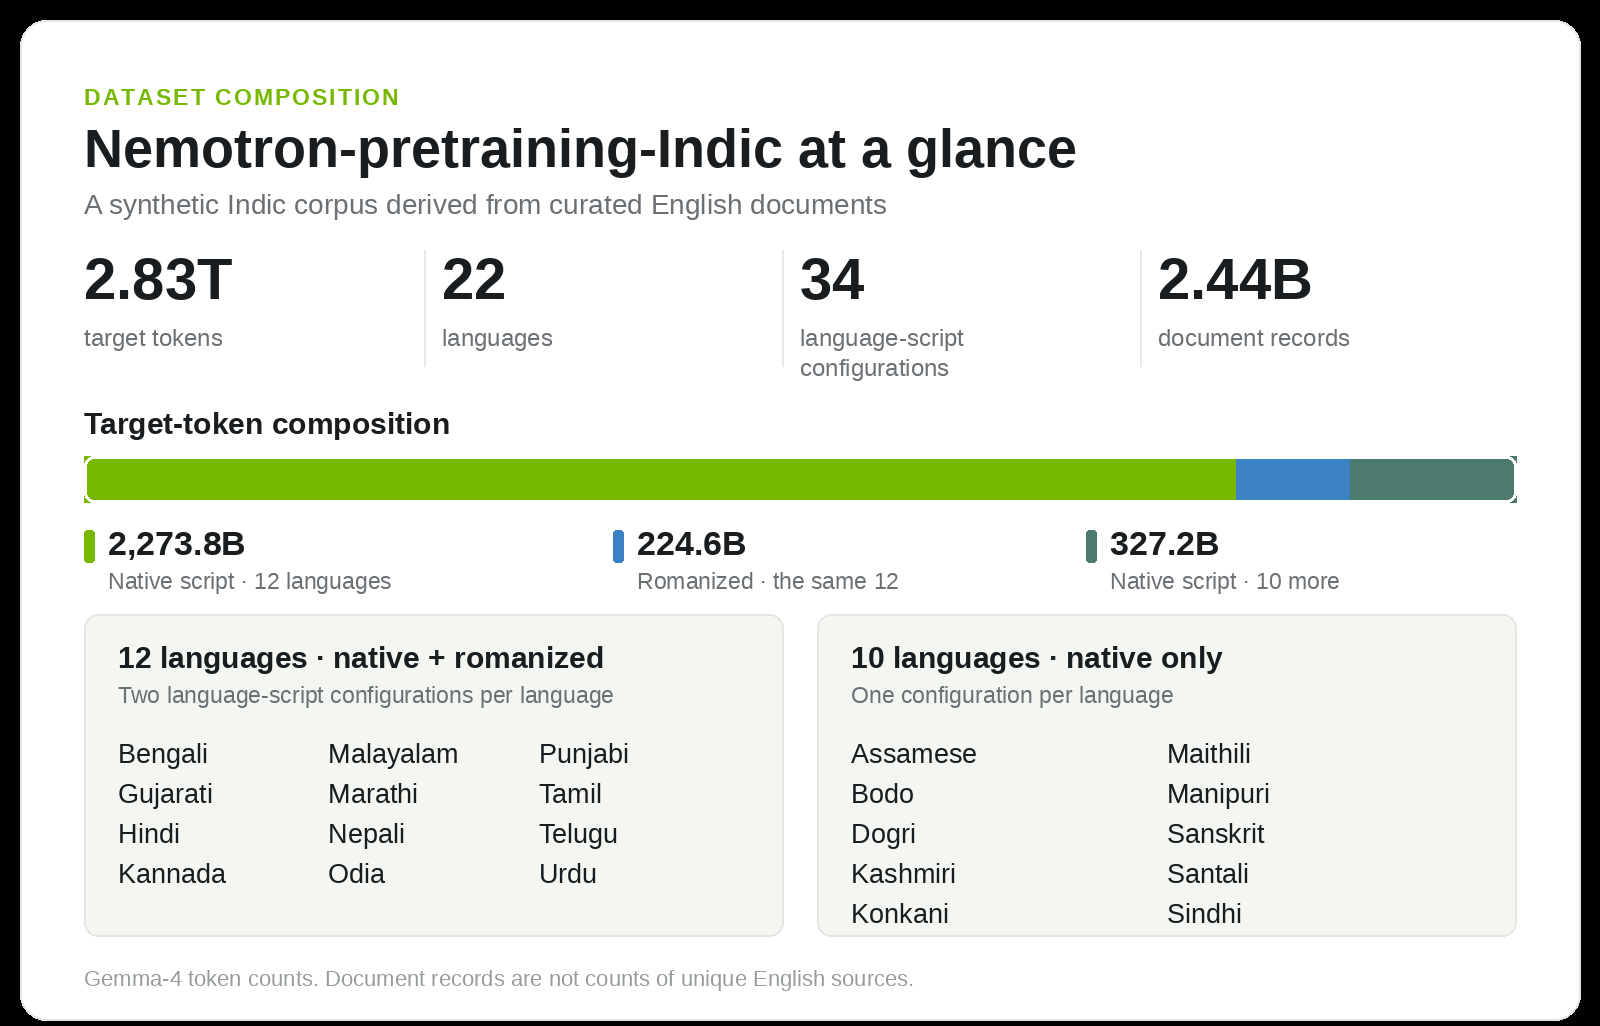
Nemotron-pretraining-Indic-v1 — это примерно 2,8 трлн токенов на 22 языках из Конституции Индии, родных для 97 % жителей страны, с данными в родной графике для всех 22 языков и в латинице для двенадцати. Корпус выйдет вместе с открытым конвейером генерации данных на GPU, который включает промпты, рабочие процессы на языковых моделях и проверки качества. Ни даты выхода корпуса, ни его лицензии в публикации нет; часть замеров в ней — это сравнение этапов обучения, а не финальных релизов моделей.
Что объявили
NVIDIA вместе с IIT Madras и его лабораторией AI4Bharat представила Nemotron-pretraining-Indic-v1 — примерно 2,8 трлн токенов на 22 языках Индии. Корпус, как сказано в публикации, выйдет вместе с открытым конвейером генерации данных на GPU, которым этот корпус и был собран.
Речь именно о 22 языках, перечисленных в Конституции Индии: это родные языки для 97 % жителей страны, то есть для почти 1,2 млрд человек по переписи 2011 года.
Конвейер публикуется не как чёрный ящик: в нём раскрыты промпты, рабочие процессы на языковых моделях и проверки качества, чтобы команды могли перенести рецепт на свои исходные документы и генерировать больше данных под свои задачи.
Дата выхода корпуса, его лицензия и адрес загрузки в публикации не названы — сказано только, что он выйдет.
Из чего состоит корпус
Объём разложен по графике: 2 601,0 млрд токенов в родных системах письма и 224,6 млрд токенов в латинице, подсчёт по токенизатору Gemma-4.
Языковых конфигураций 34. Первая группа — данные в родной графике и в латинице для бенгальского, гуджарати, хинди, каннада, малаялам, маратхи, непальского, ория, панджаби, тамильского, телугу и урду; вторая — только родная графика для ассамского, бодо, догри, кашмирского, конкани, майтхили, манипури, санскрита, сантали и синдхи.
Авторы отдельно предупреждают, как читать эти числа: родная графика здесь не означает, что текст написан носителем — он всё равно переведён с английского, а латиница означает индийский язык, записанный латинскими буквами, а не английский перевод. Для каждого из двенадцати языков с двумя графиками латинизация покрывает лишь часть принятых переводов.
Два уточнения важны для планирования обучения: токены описывают сохранённый корпус, включая принятые после доработки записи, а не бюджет обучения конкретной модели, и подсчёт зависит от токенизатора. Кроме того, записи включают переводы и варианты графики одних и тех же источников, поэтому это не число уникальных английских документов.
Как корпус построен
Исходный материал — документы из 15 наборов Nemotron-CC-v2: веб-текст, вопросы и ответы, математика, код и другое специализированное содержимое. Генерацию ведёт NeMo Data Designer, открытый фреймворк NVIDIA для синтетических данных. Идентификатор источника сохраняется на всём пути, так что результат можно проследить до исходного документа.
Для двенадцати языков документ переводится целиком, чтобы модель использовала контекст абзацев, таблиц и формул. Модель выбрали сравнением на полных документах: это Gemma-4-31B-it. Промпты отделяют текст, который нужно перевести, от содержимого, которое нужно сохранить, — кода, формул, адресов и разметки.
Там же оценивается качество: та же модель сверяет результат с английским источником по рубрике, вдохновлённой Multidimensional Quality Metrics, по смыслу, беглости, терминологии, стилю и оформлению. Остаются оценки не ниже 75 из 100 — это балл рубрики, а не процент точности. Для низких оценок замечания оценки используются как подсказка для доработки, после чего результат проверяют снова. Такой цикл вернул 438,4 млрд токенов в родной графике и латинице, и эти токены уже входят в общий объём.
Латиница строится вторым шагом: часть принятых переводов конвертируется в латинские буквы и сверяется с исходником в родной графике. По первичному сравнению с участием людей такой двухшаговый путь дал меньше выдуманных добавлений и меньше остаточного английского, чем прямая генерация латиницы из английского.
Для остальных десяти языков применён другой путь: перевод документов моделью Indic Translate от Bodhan AI, рассчитанной на английский и 22 языка Индии, а оценка — снова на Gemma-4-31B-it. Восемь языков переводятся целиком; для длинных документов сантали применяются перекрывающиеся окна с последующей сборкой, а манипури переводится сначала в бенгальскую графику и затем конвертируется в родную Meitei Mayek. Порог 75 из 100 сохранён, доработки по подсказкам оценки здесь нет — только данные в родной графике.
Что это дало Nemotron 3.5 Super VL
Продолженное предобучение Nemotron 3.5 Super VL добавило 10 млрд индийских токенов, взятых из подмножества этого корпуса на двенадцать языков и из естественного индийского текста; то же название корпуса и то же число токенов называет техническая публикация NVIDIA об этой модели.
Бюджет того этапа — 100 млрд токенов, из которых 10 % (10 млрд) отдано смеси синтетического и естественного индийского текста. Оценки выросли на всех пяти названных бенчмарках: MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy и Indic GSM8K, прирост от 4,98 до 9,82 процентного пункта.
Авторы сами ограничивают это сравнение: оно сделано между контрольными точками одного этапа обучения, а не между финальными релизами моделей, и в нём не отделён вклад синтетического корпуса от естественного текста. GSM8K приводится без ория, потому что оценка вышла за пределы контекста обслуживания.
Отдельно сравнивается выпущенная модель с Nemotron 3 Super: она выше в пяти из шести показанных задач — знания, рассуждения, математика, код и перевод, — но на 2,04 пункта ниже по следованию инструкциям в IFEval 1.5. Улучшение заявлено по всем четырём измерениям IndiVibe, открытого бенчмарка Sarvam AI с промптами в стиле ассистента на индийских языках, но сами авторы называют эти оценки предварительными условными предпочтениями, а не прямыми сравнениями «в одну сторону».
Что можно взять уже сейчас
Вместе с корпусом открыт плагин Nemotron Bharat для NeMo Data Designer: промпты перевода и оценки, необязательная доработка по обратной связи, оконная обработка документов и переключение графики. В публикации предложено начинать с небольшой выборки своих же документов, проверять сохранность кода, математики и разметки и лишь потом масштабировать, а генерацию и приёмку корпуса держать раздельными шагами: плагин возвращает кандидатов и оценки, а решение о фильтрации остаётся за той, кто собирает корпус.
Отчёт о корпусе опубликован отдельным набором данных на Hugging Face с отчётом в PDF и лицензией CC BY 4.0.
Для конфигураций используются теги языка, графики и региона — например, hi-Deva-IN для хинди в деванагари и hi-Latn-IN для хинди латиницей. Среди сопутствующих ресурсов названы наборы для постобучения Nemotron и Nemotron-Personas-India с синтетическими персонами на английском и хинди.
Партнёры и инструменты
Работу ведут NVIDIA, IIT Madras, AI4Bharat и Bodhan AI — некоммерческий центр ИИ в образовании при IIT Madras. В благодарностях названы модель Gemma от Google, модель Indic Translate от Bodhan AI и NeMo Data Designer.
Глава AI4Bharat Митеш Кхапра, вошедший в список TIME100 AI 2025 года, формулирует задачу так: «у нас недостаточно данных для индийских языков». Ответом авторы называют больше данных плюс открытый рецепт, чтобы эти данные можно было генерировать дальше.
Рядом идёт работа над оценкой: AI4Bharat при IIT Madras при поддержке NVIDIA собирает Indic-LLM-Eval-Suite — открытый и пополняемый набор бенчмарков для индийских языков, с отдельной публикацией «Better Models Need Better Benchmarks».
Чего в объявлении нет
Авторы прямо говорят, что перевод расширяет доступ к исходному материалу, но не заменяет текст, изначально написанный на индийских языках, и не гарантирует покрытия местных знаний и культурного контекста; корпус предложено сочетать с естественным индийским текстом и проверять получившуюся смесь под свою задачу.
Оценка качества в основном автоматическая, выборочные проверки людьми есть, но их покрытие различается по языкам; в процессе для двенадцати языков переводчик выступает и судьёй. Сохранённый текст может содержать ошибки, а путь для десяти языков, по признанию авторов, требует более широкой проверки носителями.
Проверки по идентификаторам источников убирают дубли обработки, но не являются семантической дедупликацией похожего содержимого.
Наконец, сами замеры прироста — это заявление авторов о сравнении этапов обучения их модели, опубликованное вместе с публикацией, а не независимая проверка третьей стороной; независимых испытаний корпуса в публикации не приводится.
Первоисточники
- NVIDIA — «Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline» (16 октября 2026)
- NVIDIA Technical Blog — «NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning» (15 октября 2026, 18:01 UTC)
- NVIDIA — набор с отчётом о корпусе Nemotron Indic (отчёт в PDF, лицензия CC BY 4.0)