Исследования
IBM и NASA открыли модель-основу для карт Луны
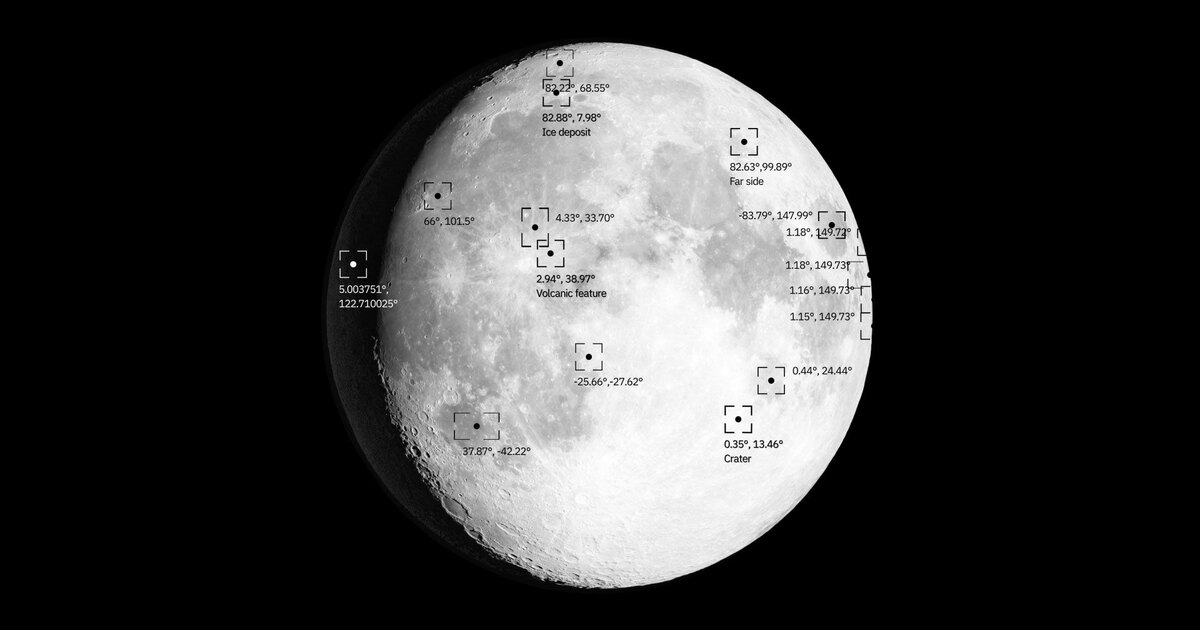
Мультимодальная NASA-IBM Lunar Foundation Model сводит десятилетия наблюдений американских и японских миссий в одно представление: она на 22% точнее ищет лёд в полярных кратерах и распознаёт кратеры при вдвое меньшем объёме обучающих данных.
Одна модель вместо десятков наборов данных
IBM и NASA открыли самую подробную на сегодня модель для картографирования Луны. Она объединяет и приводит к общему виду данные, собранные за десятилетия американскими и японскими миссиями.
Модель называется NASA-IBM Lunar Foundation Model. Это первая ИИ-модель, которая объединяет наблюдения, полученные в разных модальностях, под разными углами обзора и в разных пространственных масштабах. Сведя разнородные измерения в одно представление, исследователи получили модель Луны, которую — как и более ранние модели Земли и Солнца Prithvi EO и Surya — можно быстро адаптировать под разные задачи и переиспользовать.
NASA сразу определила три приоритетных применения: картирование мелких неучтённых кратеров, изучение вулканической истории Луны и поиск льда в кратерах на обоих полюсах. Лёд рассматривается как потенциальный источник питьевой воды, кислорода и топлива для будущих экипажей.
Почему лунные данные так трудно объединить
Задача, которую решает модель, связана с большим объёмом многодатчиковых данных разного масштаба. Миссия NASA GRAIL картировала гравитационное поле Луны с разрешением около 20 километров на пиксель, чтобы показать кору и недра, а Lunar Reconnaissance Orbiter (LRO) искал лёд в тёмных полярных кратерах и снимал небольшие валуны и кромки кратеров с разрешением около метра на пиксель.
Чтобы согласовать столь разные измерения, IBM и NASA взяли версию TerraMind — модели наблюдения Земли, разработанной IBM и Европейским космическим агентством (ESA). TerraMind хорошо интегрирует разные типы данных и разрешения и учится кросс-модальным связям, чтобы заполнять пропущенные или зашумлённые значения.
Отдельная сложность — освещение. Лунные сутки состоят из двух недель света и двух недель темноты, из-за чего облик одних и тех же объектов сильно меняется. Практически полное отсутствие атмосферы усиливает эффект: без облаков и воздуха, рассеивающего свет, Луна — это мир резких границ и контрастов, где пики и впадины скрываются в глубоких тенях и ярких бликах. На полюсах, где Солнце висит низко над горизонтом, рельеф отбрасывает длинные тени и прячет камни и кратеры.
Добавляют сложности температуры: в полном свете поверхность нагревается до 250 °F (121 °C), а в затенённых кратерах опускается до −410 °F (−246 °C). Детальная тепловая карта помогла бы искать лёд и выбирать безопасные места для базы, но повышение разрешения тепловых данных NASA обычным моделированием требует времени, денег и больших вычислительных ресурсов.
Что модель уже умеет
Для дообучения использовали лёгкие низкоранговые адаптеры (LoRA), которые оставляют замороженными 90% весов базовой модели. Несмотря на такую экономичную настройку, модель как минимум не уступала традиционным моделям машинного обучения, а на части задач их превзошла.
В задаче поиска льда, где по незнакомому снимку нужно определить, может ли тёмный полярный кратер содержать лёд, модель снизила частоту ошибок на 22% по сравнению с передовым трансформером SwinV2, обученным именно для разведки льда.
Кратеры модель распознаёт с разрешением один метр на пиксель так же точно, как Swin, специально обученный на кратерах. На более грубом разрешении — 100 метров на пиксель — она превзошла ту же модель почти на 19%, потратив вдвое меньше обучающих данных.
Наконец, при картировании границ вулканических образований, так называемых irregular mare patches, модель обошла задачно-специфичный Swin на 3%, дав сопоставимую точность при меньшей стоимости.
Что внутри и что дальше
Технически это мультимодальная модель с несколькими разрешениями: кодировщик и декодировщик ViT-B (768 измерений, 12 слоёв, 12 голов) обучены с нуля на SomBench — примерно двух миллионах совместно зарегистрированных лунных наборов, охватывающих 11 модальностей: девять плотных изображений, оптические метаданные тайла и статическая карта контекста.
В двух масштабах это 963 609 наборов LROC WAC (около 100 метров на пиксель) и 1 000 113 наборов LROC NAC (около одного метра на пиксель), разделённых географически. Предобучение шло на 16 ускорителях H100 за 150 тысяч шагов при глобальном батче 1536 и заняло около 1,1 тысячи GPU-часов; в качестве явного контекста модель получает углы освещения, привязку к солнечной системе координат и контур тайла.
В отличие от TerraMind лунная версия добавляет геометрию съёмки как явный контекст и совместное предобучение на смешанных разрешениях: тайлы, привязанные к NAC и WAC, обучаются в одном цикле при собственном разрешении, поэтому один набор весов покрывает обе семьи разрешений с разрывом в 100 раз. Благодаря FlexiViT-эмбеддингу патчей checkpoint можно дообучать при других размерах патча, а модальность-специфичная токенизация позволяет добавлять или убирать модальности на этапе дообучения.
Модель распространяется под лицензией Apache-2.0, а авторы прямо оговаривают границы применимости: это не научно-пригодный генеративный продукт, и сгенерированные поля не являются калиброванными предсказаниями. Речь о переиспользуемом представлении для лунного дистанционного зондирования, которое можно дообучать под детекцию, сегментацию и плотную регрессию.