Исследования
Microsoft уменьшила pathology foundation models: GigaPath-Flash и GigaTIME-Flash
Компактный ViT-S backbone сохраняет близкое качество whole-slide анализа при примерно 50-кратном снижении compute, а spatial proteomics работает быстрее и требует меньше памяти.
Pathology-модели упираются в масштаб эксперимента
Microsoft Research представила GigaPath-Flash и GigaTIME-Flash — более компактные варианты моделей для анализа whole-slide pathology images и восстановления spatial proteomics из обычных H&E-снимков. Обе модели предназначены для исследований и не валидированы для diagnosis, prognosis, treatment selection или других решений по уходу за пациентом.
Whole-slide image часто превышает гигапиксель и требует обработки тысяч tiles. В исследовании на десятках тысяч пациентов стоимость растёт не только из-за одного model run: feature extraction приходится повторять для статистического анализа, проверки гипотез, разных patient subgroups, biomarkers и clinical endpoints.
Семейство Flash нацелено именно на повторяемость таких экспериментов. Microsoft заявляет сохранение полезных pathology representations при существенном сокращении ресурсов и выпускает обе модели как open weights под Apache 2.0 вместе с кодом на Hugging Face.
Один компактный backbone для двух задач
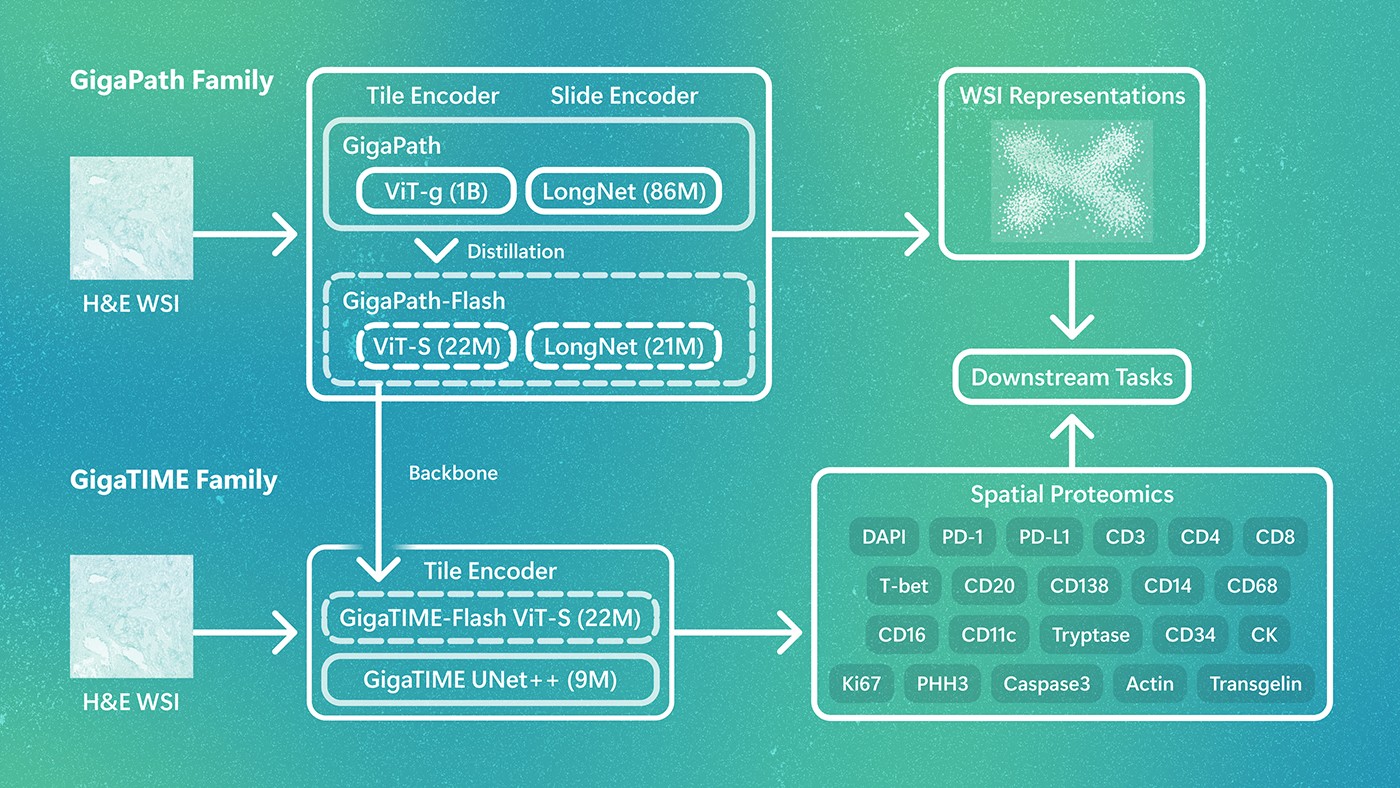
Общая основа двух моделей — ViT-S tile encoder на 22 млн параметров, дистиллированный из исходного billion-parameter GigaPath ViT-g. GigaPath-Flash дополняет его LongNet slide encoder на 21 млн параметров, который контекстуализирует embeddings всех tiles через dilated attention с линейным масштабированием по их числу.
GigaTIME-Flash использует тот же ViT-S вместо CNN backbone оригинальной GigaTIME и добавляет лёгкий convolutional decoder для H&E-to-mIF translation. Fine-tuning выполняется через LoRA adapters, поэтому большая часть pretrained encoder weights остаётся замороженной.
Исходная GigaTIME была обучена на 40 млн клеток с парными H&E и multiplex immunofluorescence данными и строила виртуальные spatial proteomics maps по 21 protein channel. В новой версии меняется вычислительная основа, но сохраняется задача моделирования tumor microenvironment.
GigaPath-Flash: примерно 50 раз меньше compute
На slide-level classification benchmarks PANDA для prostate grading и EBRAINS для brain tumor subtyping GigaPath-Flash показала минимальную inference cost среди сравниваемых whole-slide pretrained models. Результат находился в пределах 3% от оригинальной GigaPath при примерно 50-кратном сокращении compute.
В сводной таблице Microsoft формулирует тот же trade-off как 97% predictive performance GigaPath при приблизительно 50 раз меньших вычислениях. Это не означает универсальную точность 97%: речь идёт об относительном сохранении показателя исходной модели на указанных benchmarks.
Экономия возникает не только из-за меньшего tile encoder. LongNet slide encoder использует dilated attention и линейно масштабируется по количеству tiles, что позволяет собрать контекст whole slide без возвращения к billion-parameter backbone на каждом фрагменте.
GigaTIME-Flash: быстрее и устойчивее на новых cohorts
На in-distribution и out-of-distribution cohorts по brain, breast, colon и lung cancers GigaTIME-Flash, по данным Microsoft, совпала с оригинальной GigaTIME или превзошла её по качеству spatial protein prediction. Особенно заметные улучшения отмечены на ранее не встречавшихся tissue types.
По эффективности Microsoft сообщает примерно шестикратное ускорение и приблизительно восьмикратное снижение memory use при лучшей predictive performance относительно GigaTIME. На графике throughput новая модель масштабируется выше 1 600 tiles в секунду, используя лишь часть прежней памяти.
Для расчёта virtual mIF при примерно 10 000 tiles на slide компания оценивает 1 000 slides примерно в 2 GPU-hours на одной A100, 100 000 — примерно в 7 GPU-days, а миллион — примерно в 70 GPU-days. Для исходной GigaTIME приведены около 7 GPU-hours, 30 и 300 GPU-days соответственно.
Открытый release с жёсткой клинической границей
Model weights и код GigaPath-Flash и GigaTIME-Flash опубликованы под Apache 2.0. Microsoft называет выпуск ранним research release: текущая evaluation охватывает ограниченный набор benchmarks и cohorts, а более широкая проверка на других tasks, scanners, institutions и populations ещё нужна.
Компания отдельно предупреждает, что downstream clinical applications потребуют multi-institutional и prospective validation. Даже совпадение или улучшение benchmark-метрик не превращает исследовательскую модель в диагностический инструмент и не подтверждает безопасность решений по конкретному пациенту.
Проект выполнен совместно Microsoft Research, University of Washington и Providence. Предыдущая GigaTIME применялась более чем к 14 000 cancer patients и выявила свыше 1 200 статистически значимых ассоциаций между immune cell states и clinical biomarkers; Flash-семейство должно сделать подобные population-scale циклы дешевле для повторения и расширения.
Практический смысл — больше проверяемых гипотез
Снижение compute на одном slide важно, но основной эффект проявляется на cohort-scale. Если feature extraction занимает недели вместо месяцев, исследователи могут повторить анализ с другими endpoints, проверить больше subgroups и быстрее обнаружить, где модель перестаёт переноситься на новую выборку.
При этом эффективность не устраняет риск dataset shift. Сама Microsoft отмечает возможные различия между scanners, institutions, populations и use cases; заявленная generalization GigaTIME-Flash основана на перечисленных cohorts и должна проверяться за их пределами.
GigaPath-Flash и GigaTIME-Flash поэтому стоит читать не как готовую клиническую систему, а как инфраструктурное улучшение научного цикла: компактный общий encoder, открытые weights и измеренная экономия ресурсов делают крупные повторные эксперименты достижимее, сохраняя необходимость независимой валидации.