Исследования
«Ушли от сложных actor-critic схем к групповым алгоритмам»: разбор на Hugging Face сравнил шесть методов RL-выравнивания
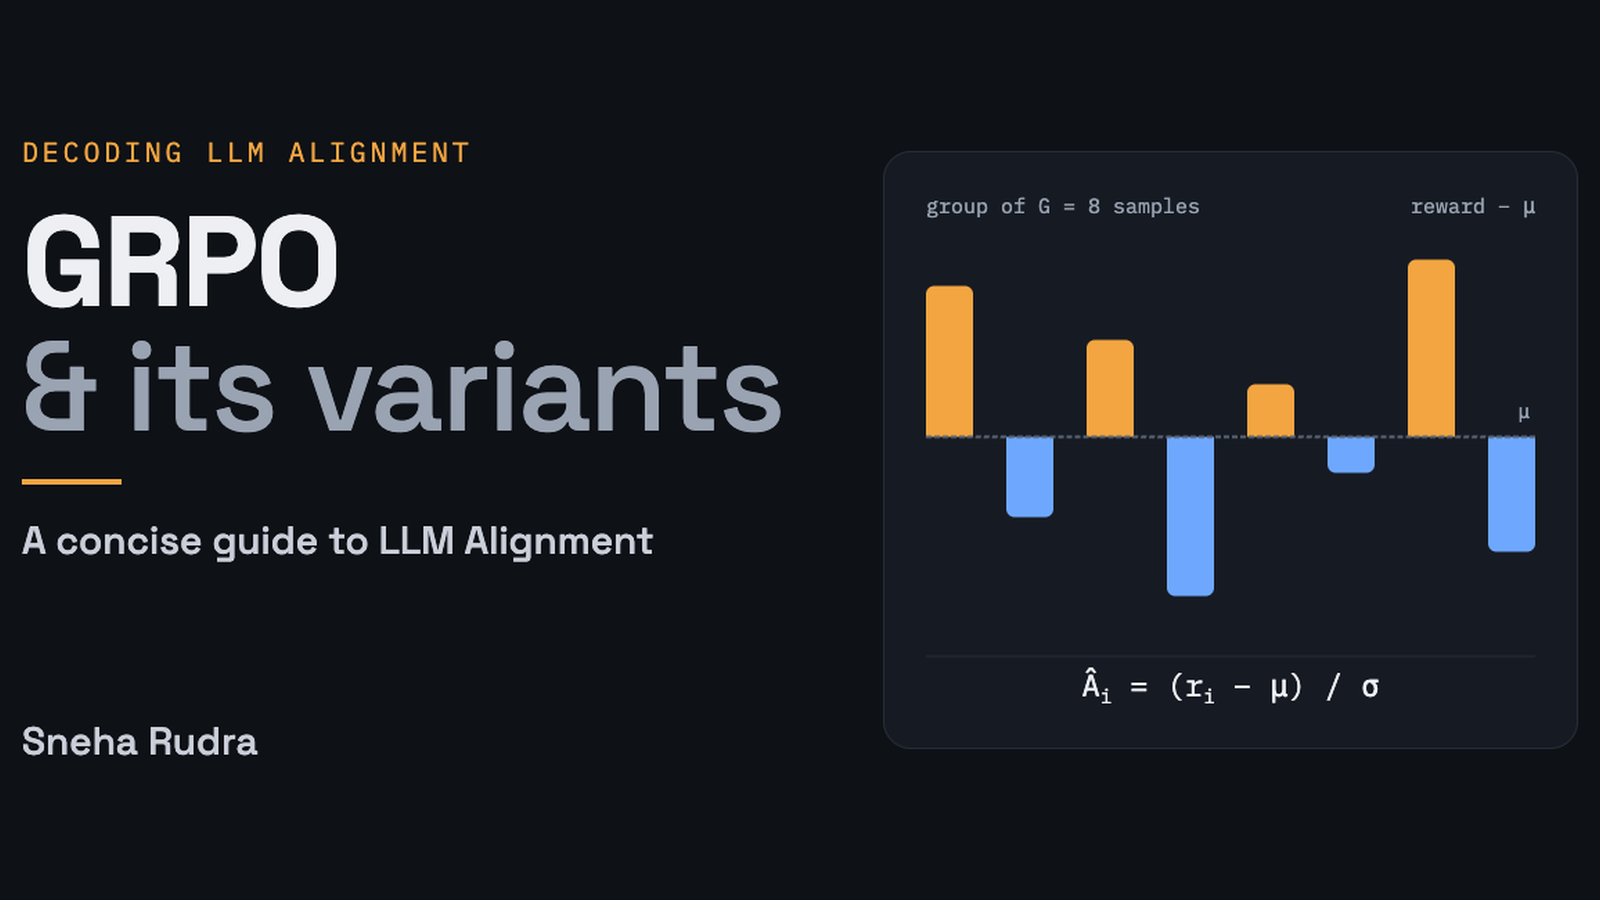
4 октября 2026 года в блоге Hugging Face вышла авторская статья Sneha Rudra «Decoding LLM Alignment: A Concise Guide for GRPO and its variants»: автор сводит в одну таблицу шесть алгоритмов обучения с подкреплением, которыми выравнивают языковые модели, — PPO, RLOO, GRPO, Pref-GRPO, GSPO и GDPO. Общий смысл разбора в том, что выравнивание ушло от схем с отдельным критиком к групповой нормировке и оптимизации на уровне всей последовательности.
О чём разбор
4 октября 2026 года в блоге Hugging Face вышла статья Sneha Rudra «Decoding LLM Alignment: A Concise Guide for GRPO and its variants». Это обзорная работа: автор описывает, как обучение с подкреплением для выравнивания языковых и визуальных моделей перешло от сложных схем с отдельным критиком (actor-critic) к алгоритмам с групповой нормировкой и оптимизацией на уровне последовательности, и разбирает шесть конкретных методов.
В разбор вошли PPO (Proximal Policy Optimization), RLOO (REINFORCE Leave-One-Out), GRPO (Group Relative Policy Optimization), Pref-GRPO (Preference GRPO), GSPO (Group Sequence Policy Optimization) и GDPO (Group Reward Decoupled Policy Optimization). Автор сводит их в одну сравнительную таблицу с четырьмя колонками: какую задачу решает метод, как он работает, когда его применять и какую роль он сыграл в развитии обучения с подкреплением для языковых моделей.
Общая механика
Механика у всех методов одна. На этапе обучения с подкреплением алгоритм обновляет веса модели-политики — того самого LLM, который выравнивают, — сдвигая их в сторону ответов с более высокой «выгодой» (advantage). Выгода показывает, насколько конкретный сгенерированный ответ лучше или хуже базовой линии (baseline).
Различаются методы тем, как они строят эту базовую линию и на каком уровне — токена или всей последовательности — считают обновление. Именно это автор и раскладывает по таблице.
Что делает каждый метод
PPO — классический стандарт RLHF: отдельная модель-критик выдаёт оценку ценности для каждого токена (насколько хорошим, вероятно, будет продолжение ответа с этого места), а обновление идёт усечёнными (clipped) градиентами политики. Метод выбирают, когда нужна точность на уровне токенов и есть память и вычисления под сеть-критик.
RLOO (REINFORCE Leave-One-Out) убирает критика: базовой линией становится средняя награда остальных ответов из той же группы. Это снимает заметный расход памяти и вычислений на лишнюю модель — автор называет такой шаг «разворотом в сторону эффективности», уведшим индустрию от тяжёлых схем с критиком.
GRPO (Group Relative Policy Optimization) решает проблему высокой стоимости обучения модели рассуждать на математике и коде: метод генерирует несколько ответов на один запрос и вычисляет выгоду для каждого как разницу между наградой этого ответа и средней наградой группы. Применять его автор советует при обучении моделей на математике и коде с автоматическими проверками. GRPO он называет «движком» эпохи рассуждающих моделей и указывает, что это ядро reasoning-моделей вроде DeepSeek-R1.
Pref-GRPO (Preference GRPO) меняет сам сигнал награды: вместо сырых оценок внутри группы используется попарная «победа» (winrate) одного ответа против другого. Это нужно, когда модель выравнивают на парах предпочтений без отдельного критика или верификатора, а критериев несколько и они субъективны.
GSPO (Group Sequence Policy Optimization) переносит всю математику оптимизации — отношения вероятностей и усечение — с уровня токена на уровень всей последовательности, то есть ответа целиком. Сделано это под крупные модели, в том числе разреженные MoE, где обновления на уровне токенов дают высокую дисперсию градиентов и срывы обучения.
GDPO (Group Reward Decoupled Policy Optimization) нужен, когда требуется совместить несколько целей: награда за каждую цель нормируется независимо и только потом складывается, чтобы сигнал не «схлопывался» и не терял тонкие компромиссы — например, между точностью, безопасностью и краткостью.
Зачем это вместе и в чём рамка
Практическая задача разбора, по словам автора, простая: при проектировании пост-тренировки, при масштабировании рассуждающей модели или при подготовке к собеседованию по ИИ удержать в голове все эти изменения тяжело, поэтому шесть методов сведены в одно сравнение. Отдельный раздел статьи — визуальный разбор (visual walkthrough) того, как каждый метод обрабатывает группу из K ответов, сгенерированных моделью на один запрос.
Вывод автора такой: по мере того как обучение с подкреплением для языковых моделей выходит за рамки одной награды и одного рецепта обучения, понимание того, как каждый метод строит сигнал обучения, становится обязательным для выбора подходящего инструмента под нужное поведение.
Стоит держать в уме рамку: это авторская статья сообщества на Hugging Face, а не публикация компании — разработчика какого-либо из методов. Она обобщает и сравнивает уже известные алгоритмы (PPO, GRPO и их варианты), а не сообщает о новом релизе или новом результате, поэтому сведения о применимости и о роли каждого метода — это изложение и оценки автора без независимого подтверждения. Названия и аббревиатуры методов — PPO, RLOO, GRPO, Pref-GRPO, GSPO, GDPO — оставлены как есть, без перевода.