Исследования
Hugging Face обучила coding-модель рисовать акварель JavaScript-кодом
Открытый эксперимент использует TRL, OpenEnv, p5.brush и GRPO, а эстетическую награду собирает из HPSv3 и сравнений с вручную отобранным пулом.
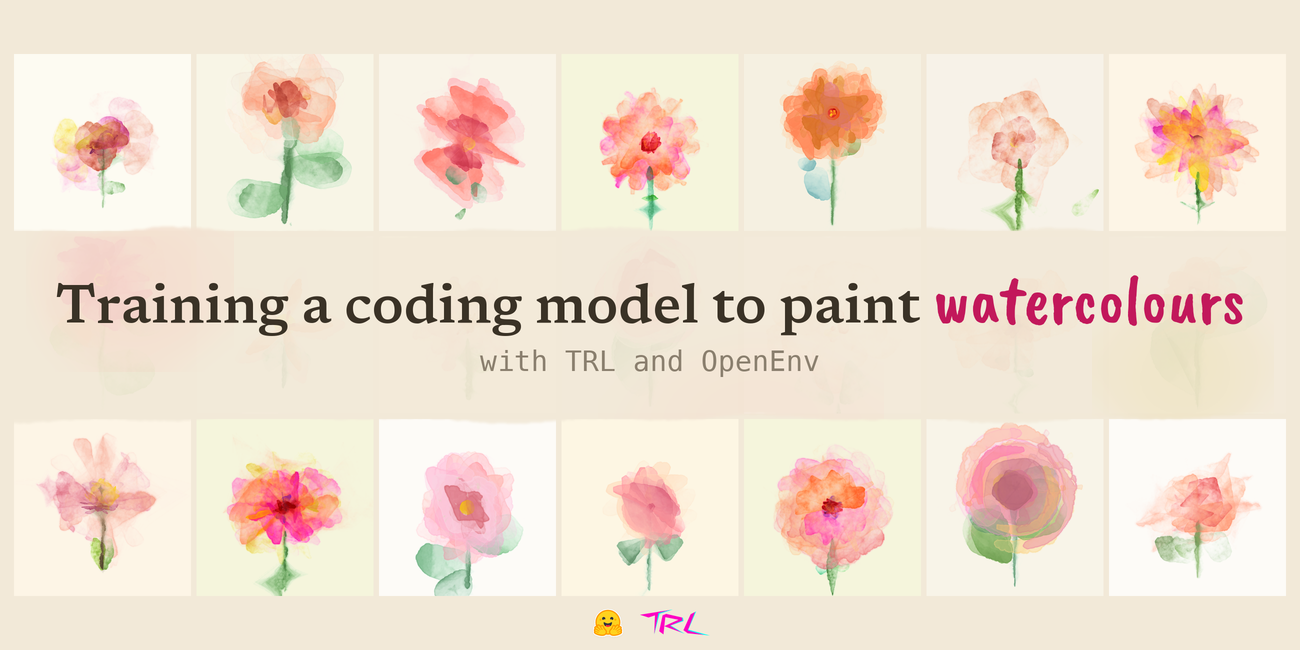
Когда результат модели — исполняемый рисунок
Инженер Hugging Face воспроизвёл в открытом виде идею Сурьи Наредди: языковая модель не генерирует пиксели напрямую, а пишет JavaScript-программу для библиотеки p5.brush. Код можно прочитать, изменить и снова исполнить, а каждый мазок остаётся частью явной программы. В эксперименте опубликованы reference pool, RL environment, training scripts, обученные adapters, rollout datasets и метрики, поэтому работа задумана не как визуальная демонстрация, а как воспроизводимая инженерная система.
Модель ограничена десятью методами p5.brush из 47 доступных. Она может создавать заполненные формы, задавать bleed и texture, но не получает линии, штриховку и произвольные кисти. Это ограничение формирует стиль не хуже текстовой инструкции: библиотека сама добавляет растекание пигмента и фактуру бумаги, а узкий API не даёт легко уйти к гладкой векторной графике. Средний ответ — примерно 150 строк JavaScript, которые headless Chromium превращает в изображение.
Среда проверяет, что программа компилируется, действительно рисует, использует разрешённую библиотеку и не пытается обмануть оценщик, например текстом на холсте. Это gate-компонент награды. Остальная часть отвечает за вкус: HPSv3 оценивает предпочтительность изображения относительно описания, а Qwen3-VL-30B-A3B-Instruct сравнивает кандидата с четырьмя примерами из подготовленного пула.
Пул изображений превращается в определение вкуса
Reference pool содержит 178 сгенерированных акварелей гибискуса, вручную разделённых автором на love и okay. Их исходные p5.brush-программы также опубликованы. Для каждого сравнения половина образцов берётся из одной категории, половина — из другой, чтобы слабая политика на ранних шагах иногда получала полезный сигнал. В таком устройстве набор примеров не просто данные: он фактически задаёт, какие прозрачные заливки, мягкие края и композиции считаются хорошими.
В исходной смеси gate и длина кода получают по 0,05, pairwise judge — 0,60, HPSv3 — 0,30. Автор сравнил три режима: judge-led, hps-led и hps-only. Первые два прошли 110 шагов, последний — 60. Средняя групповая награда выросла с 0,45 до 0,72 в judge-led, с 0,57 до 0,82 в hps-led и с 0,58 до 0,71 в hps-only, если сопоставлять первую и последнюю треть обучения.
Результаты показывают две разные формы прогресса. HPSv3 прежде всего уменьшал число почти пустых или бесформенных рисунков: медианное качество становилось стабильнее. Pairwise judge улучшал верх распределения и подталкивал модель использовать больше пигмента, приближаясь к выбранному автором стилю. При этом работы внутри каждого run становились похожими друг на друга — закономерное следствие пула, посвящённого одному цветку.
Что потребовалось, чтобы обучение вообще началось
Несколько ранних запусков давали плоскую кривую награды. Рабочая конфигурация появилась после четырёх изменений: learning rate подняли с 2e-5 до 5e-5, linear scheduler заменили на constant_with_warmup, scale_rewards переключили с group на none, а LoRA target_modules — на all-linear. Последнее было важно для Qwen3.5-35B-A3B: обычный список модулей, рассчитанный на dense-модель, затрагивал только десять слоёв из сорока.
Вычислительная цена остаётся высокой. Один шаг включает восемь rollout и занимает 15–18 минут; 70–80% этого времени приходится на программный рендер WEBGL в CPU Space. H200 работал около 18 часов для 60 шагов и примерно 34 часов для 110. Отдельно всё время должны быть доступны HPSv3 scorer и environment, а pairwise judge расходует квоту Inference Providers.
Эксперимент важен не только необычными картинками. Он показывает, как превратить субъективное предпочтение в обучающий сигнал, не притворяясь, что существует единственно правильная акварель. Однако субъективность никуда не исчезает: она переносится в ручной отбор 178 работ, вес компонентов и описание критерия для judge. Открытые артефакты позволяют другим исследователям заменить этот вкус своим и увидеть, как изменится политика.
Следующий логичный шаг — дать модели видеть собственный рисунок и исправлять его в несколько ходов. Текущая политика рисует словно с закрытыми глазами: получает текстовый prompt, выдаёт программу и узнаёт только итоговое число. Автор также предлагает проверить меньшие модели, потому что 4B-вариант уже умел писать корректные sketches в побочных тестах. Если он научится оптимизировать вкус, стоимость опыта может уменьшиться на порядок.