Исследования
Google показала пределы transfer learning для генетического прогноза между популяциями
Европейские данные помогают polygenic risk scores при малой японской выборке, но после роста локального cohort могут снижать точность — причём порог сильно зависит от признака.
Большая внешняя выборка полезна не всегда
Google Research исследовала, как переносить polygenic risk scores, или PRS, из крупных европейских cohorts в недостаточно представленные популяции. PRS суммируют влияние от сотен до миллионов genetic variants, но историческое преобладание европейских genome-wide association studies приводит к падению точности при применении моделей к людям другого происхождения.
В эксперименте данные сотен тысяч участников UK Biobank использовали для прогноза на Biobank Japan — глубоко фенотипированном cohort почти из 200 тысяч японских участников. Исследователи варьировали объём обеих training populations и проверяли восемь клинических признаков: BMI, systolic и diastolic blood pressure, число красных и белых клеток крови, HDL, LDL и blood glucose.
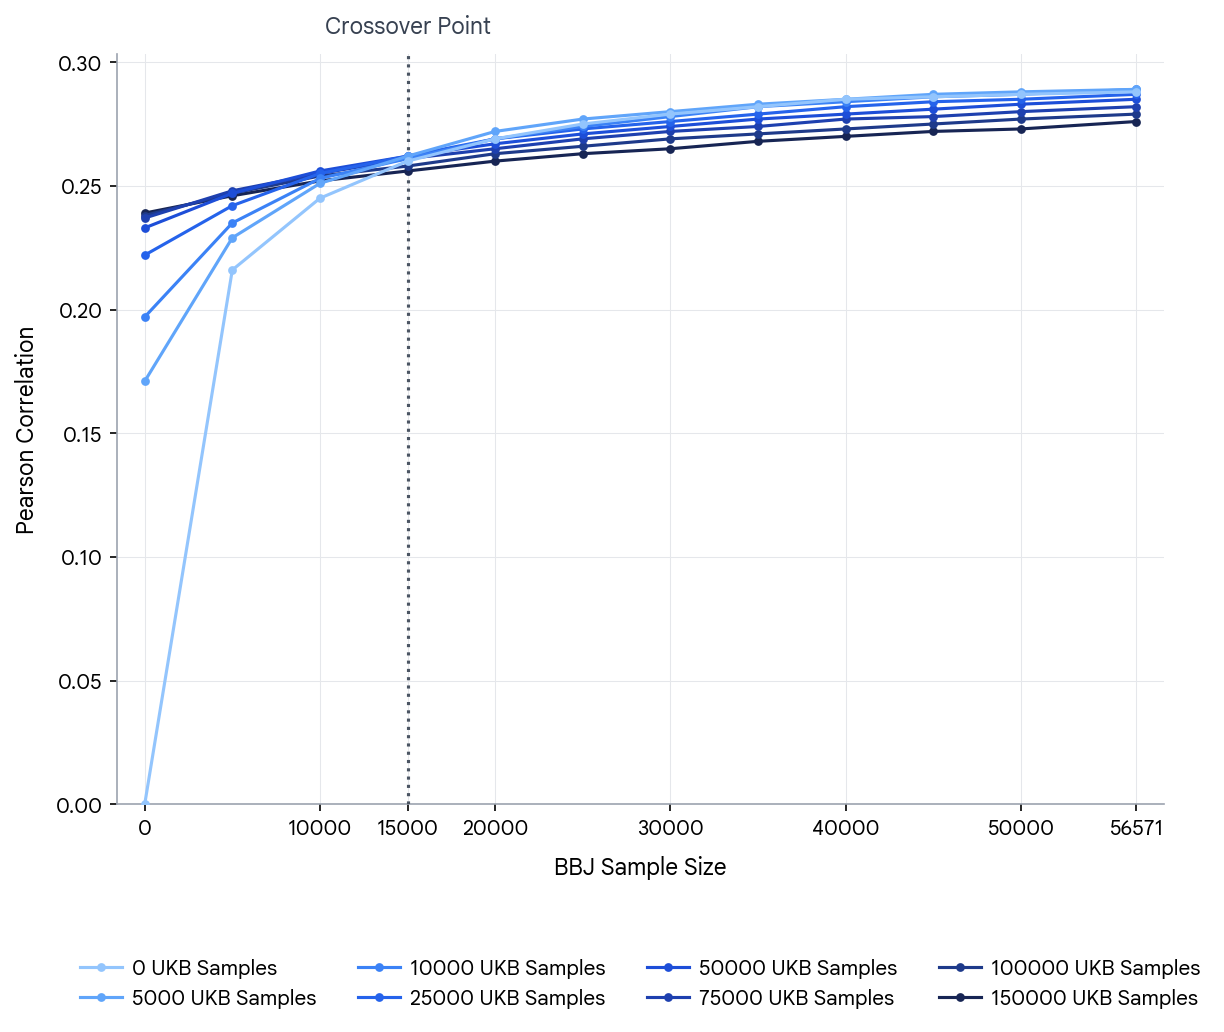
Ключевой результат противоречит правилу «больше данных всегда лучше». При очень малой целевой выборке, например 5 тысяч участников BBJ, объединение с европейскими данными давало статистическое преимущество. Но с ростом японского cohort польза внешней выборки уменьшалась, а после определённого порога co-training мог уступать модели, обученной только на целевой популяции.
Для HDL перелом наступил после 15 тысяч японских образцов
Performance всех моделей измеряли Pearson correlation на одном и том же отложенном наборе BBJ. В примере с HDL target-specific model стала лучше после 15 тысяч японских samples. За этой точкой добавление более 5 тысяч UKB samples снижало качество по сравнению с обучением исключительно на данных целевой популяции.
Общий паттерн наблюдался для всех восьми phenotypes, но точка crossover различалась. Для признаков с более высокой genetic correlation между популяциями, таких как BMI, pooling сохранял пользу до 25–40 тысяч и более target samples. Для HDL, LDL и blood glucose, чья genetic architecture оказалась более population-specific, оптимальный объём внешних данных начинал сокращаться гораздо раньше.
Это не означает, что европейские samples становятся «плохими» сами по себе. Они представляют другое распределение allele frequencies, population structure и связей между variants и phenotype. Пока локальных наблюдений мало, дополнительный signal уменьшает variance; когда их достаточно, out-of-distribution data способна сместить модель от закономерностей, наиболее полезных именно для целевой группы.
Исследователи сравнили три стратегии
Базовый подход использовал ElasticNet с variants, обнаруженными через крупный европейский GWAS. Затем команда добавила cross-population meta-analysis: отдельный GWAS проводился на каждом размере BBJ subset, его результаты объединяли с полным UKB GWAS для отбора candidate variants, после чего на них обучали ElasticNet. Третий вариант, PRS-CSx, комбинировал summary statistics двух популяций и динамически взвешивал population-specific models.
Meta-analysis мало менял результат для генетически conserved traits, поскольку меньшему BBJ GWAS не хватало statistical power. Для population-specific HDL и LDL, а в меньшей степени blood glucose, он заметно превосходил вариант с discovery только на одной популяции: локальный GWAS позволял добавить variants, которых европейская процедура отбора не замечала.
PRS-CSx оказался требовательнее к размеру target cohort. При менее чем 25 тысячах японских samples он проигрывал сильнейшему соответствующему ElasticNet почти для всех phenotypes, кроме BMI. Когда размер приближался к 100 тысячам, PRS-CSx сравнялся с лучшей моделью или превзошёл её для всех исследованных признаков, кроме blood glucose.
Одна модель не решает проблему репрезентативности
Исследование показывает, почему недостаточно взять самый большой доступный GWAS и применить его в другом healthcare system. Оптимальная стратегия зависит одновременно от размера местного cohort, сходства genetic architecture и выбранного phenotype. Универсальный порог переноса авторы не предлагают: даже внутри одного набора данных признаки пересекают точку полезности внешних samples в разное время.
Работа также не превращает PRS в готовое клиническое решение. Google отмечает, что adoption polygenic scores для clinical decision making остаётся низким, а исследование оценивает predictive correlation восьми количественных traits на held-out BBJ samples. Оно не проверяет влияние рекомендаций на здоровье пациентов, диагностику конкретного заболевания или справедливость реального медицинского workflow.
Главный инженерный урок — выбирать данные не по абсолютному объёму, а по их marginal value для заданной популяции и цели. Learning curve нужно строить отдельно по phenotype, сравнивать target-only и pooled training и не предполагать, что более сложный multi-ancestry algorithm автоматически выиграет на малой локальной выборке.
Нужны и локальные biobanks, и адаптивный выбор метода
De novo GWAS на сотнях тысяч людей слишком дорог для большинства систем здравоохранения, поэтому transfer learning остаётся практичным способом начать работу там, где локальных данных мало. Но эксперимент показывает, что он должен быть переходной стратегией, а не заменой расширению разнообразных biobanks: с накоплением target-population data локальный signal становится всё важнее.
Авторы формулируют две взаимодополняющие задачи. Первая — продолжать собирать cohorts недостаточно представленных ancestry groups, чтобы модели могли увидеть population-specific variants и связи. Вторая — подбирать modeling strategy с учётом heritability, sample size и степени shared genetics, а не механически объединять все доступные источники.
Итог работы — эмпирическая граница для лозунга о transfer learning. Большой европейский cohort действительно способен улучшить genomic prediction, когда целевая выборка мала; тот же источник способен ухудшить результат, когда локальных наблюдений становится достаточно. Для ответственного применения PRS важно знать не только сколько данных использовано, но и чьи это данные, для какого признака и на какой популяции проверен итог.