Исследования
«Расширять, а не сужать»: Google отчиталась о 300 языках, Gemini 3.5 Live Translate и переводе жестов
15 сентября 2026 года Google опубликовала пост Джеймса Маньики, старшего вице-президента по исследованиям, лабораториям, технологиям и обществу: технологии и продукты компании обеспечивают повседневные взаимодействия более чем на 300 языках, на которых говорят свыше 7 миллиардов человек — это 86% населения планеты. Дальше идёт конкретика: Gemini 3.5 Live Translate переводит устную речь на 70 языках и более чем 2 000 языковых пар, TranslateGemma работает на устройстве, а Sign Language-to-Text обучен более чем на 50 жестовых языках и стартует с американского жестового языка на Pixel 11. Для редких языков данные собирали на месте: WAXAL — 27 языков Африки южнее Сахары, Project Vaani — 109 языков Индии и более 30 000 часов речи.
Что именно Google назвала вехой
Пост вышел 15 сентября 2026 года и подписан Джеймсом Маньикой (James Manyika), старшим вице-президентом по исследованиям, лабораториям, технологиям и обществу. Главная цифра стоит в первом абзаце: технологии и продукты Google обеспечивают повседневные взаимодействия более чем на 300 языках, на которых говорят свыше 7 миллиардов человек, — это 86% населения планеты.
Второй ориентир исторический: Google Translate запустили в 2006 году, и с тех пор число языков в нём выросло с нескольких до более чем 250. Автор сразу оговаривает, что перевода текста недостаточно: по его формулировке, технологии должны понимать, как люди общаются в реальной жизни, а системы — уважать культурные нюансы и богатство языка, чтобы каждый мог быть понятым на своих условиях.
В тексте есть фраза, которая задаёт рамку всему материалу: за 20 лет исследований Google вынесла урок, что технология не должна сужать спектр человеческого самовыражения — она должна его расширять. Дальше пост показывает, из чего это складывается на практике: звук, данные, доступность и ограничения реального мира.
От транскрипта к нативной работе со звуком
Раньше распознавание речи шло жёстким многошаговым конвейером: аудио превращалось в текст, текст обрабатывался, затем синтезировался обратно в звук; по словам автора, такая схема срезает самые богатые части общения — тон, темп, эмоцию и контекст.
Люди, напоминает Google, не говорят ровными грамматическими предложениями: они смеются, перебивают друг друга, запинаются и сплетают несколько языков внутри одной фразы, как в Spanglish или Hinglish. Поэтому компания перешла от транскриптов к тому, что в посте названо native audio intelligence, — модели вроде Gemini обучаются обрабатывать звук напрямую, схватывая и звучание, и намерение.
Конкретика по продуктам такая: Gemini 3.5 Live Translate обеспечивает перевод устной речи в реальном времени на 70 языках и более чем 2 000 языковых пар, естественно удерживая переключение языков внутри фразы и эмоциональные сигналы. Gemini 3.5 Transcribe назван самой точной моделью распознавания речи Google — она превращает сырое аудио в размеченный текст даже в шумной обстановке и со сложной терминологией. На ней же работает Rambler в клавиатуре Gboard на Android: он убирает слова-заполнители, правит грамматику и пунктуацию, позволяет редактировать и переписывать текст голосовыми командами и переключаться между языками.
1,000 языков и 12 миллионов часов аудио
Инициатива 1,000 Languages Initiative сформулирована как цель поддержать 1 000 самых распространённых языков мира. Логика простая: чтобы охватить больше людей на их языке, нужно выйти за пределы языков, на которых ИИ сегодня работает лучше всего.
Технический фундамент — Universal Speech Model, обученный на 12 миллионах часов аудио: он использует cross-lingual transfer learning, то есть переносит то, что модель выучила на языках с большими данными, на языки с малым объёмом обучающих данных. Отдельно автор подчёркивает академическую базу: 25 лет открытых исследований и более 400 рецензируемых работ по речи.
Данные собирают на месте: WAXAL, Project Vaani, Amplify
Интернет непропорционально представляет несколько доминирующих языков, поэтому обучать ИИ малоресурсным языкам пришлось через локальные партнёрства, а не выкачиванием данных из сети.
WAXAL (на языке волоф — «говорить») описан как крупный открытый речевой датасет: 27 языков Африки южнее Сахары, на которых говорят более 100 миллионов человек в более чем 26 странах; в наборе сохраняются тональные вариации и разговорные ритмы, которых обычно не хватает традиционным датасетам. Среди партнёров проекта — Makerere University и Digital Umuganda.
Project Vaani делают с Индийским институтом науки (IISc) и Bhashini: по словам Google, проект картографирует языковое разнообразие Индии по регионам, а не по отдельным языкам, и на сегодня собрано более 30 000 часов речи на 109 языках от более чем 155 000 носителей.
Amplify Initiative собрала вклад более 1 600 местных экспертов и 20 университетов с четырёх континентов, включая UFMG в Бразилии, IIT Kharagpur в Индии и Makerere University в Уганде, — 15 000 мультимодальных точек данных с локальными нюансами. Отдельно упомянут открытый инструмент Language Explorer, который визуализирует репозиторий LinguaMeta и непрерывно отображает более 7 000 устных, письменных и жестовых языков. Практику Google.org в посте иллюстрируют Centre for Digital Language Inclusion и сингапурский Project Aquarium.
Когда нет ни интернета, ни смартфона
Для более чем 3 миллиардов человек надёжный доступ в интернет по-прежнему недостижим, и технология доступна только там, где она работает на месте — в том числе при ограниченном или прерывистом соединении. Ответ Google — TranslateGemma: семейство лёгких открытых моделей перевода, построенных на базе Gemini и обученных на 55 языках, которое эффективно работает прямо на устройстве, так что качественный перевод больше не требует облака.
Карточка модели TranslateGemma 4B IT на Hugging Face описывает то же семейство как лёгкие открытые модели перевода от Google на базе семейства Gemma 3, рассчитанные на перевод по 55 языкам, а их сравнительно небольшой размер позволяет разворачивать их на ноутбуках, десктопах или в собственной инфраструктуре. Формулировки двух публикаций расходятся в родословной модели: пост говорит о базе Gemini, карточка — о семействе Gemma 3, и при ссылке на происхождение модели это стоит учитывать.
Ещё один трек — телефоны, а не смартфоны. С организациями вроде Viamo Google поддерживает голосового ассистента «Ask Viamo Anything» (AVA), который приносит Gemini на обычные feature-фоны: в Руанде сервис прошёл пилот на существующих пользователях голосового меню, и, по данным поста, с помощью Gemini там уже ответили более чем на 2 миллиона вопросов.
Доступность: жесты, произношение, нестандартная речь
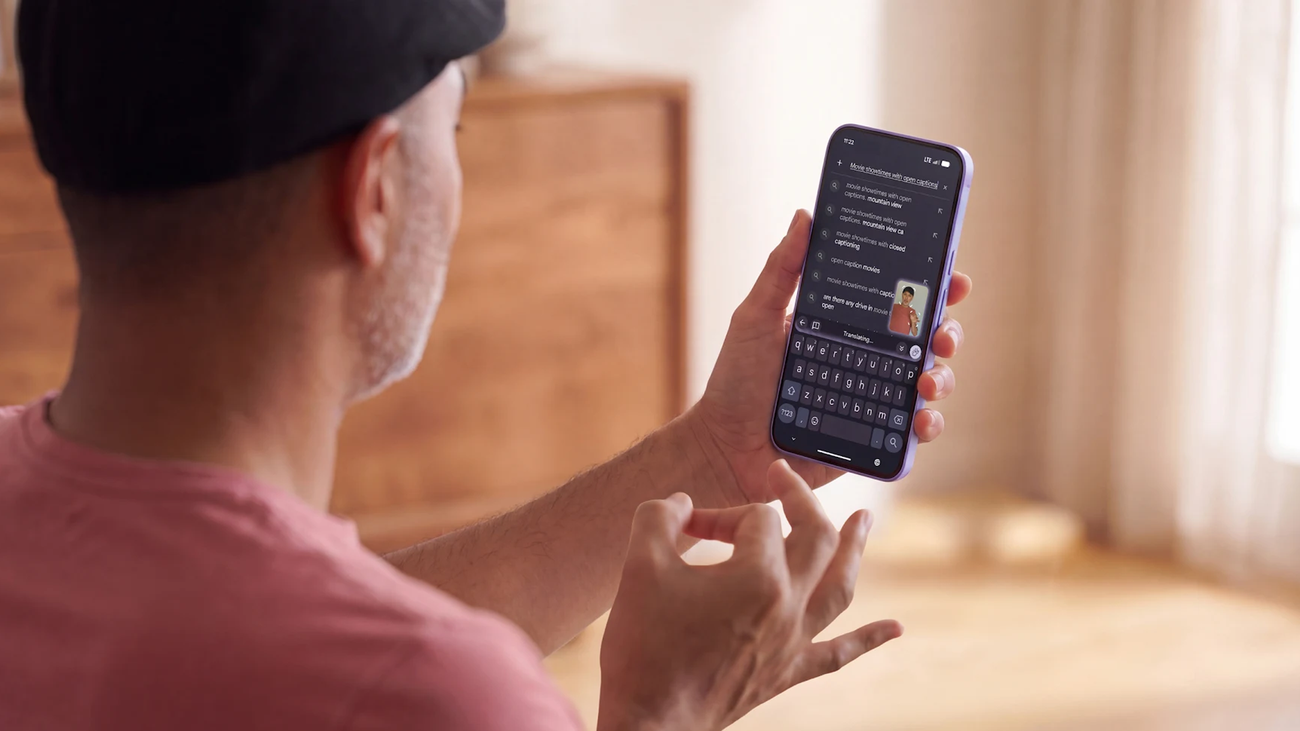
Обычные речевые инструменты, по признанию Google, часто не работают для людей с нестандартной речью, и человеку приходится подстраиваться под технологию, а не наоборот. Sign Language-to-Text (SL2T) обучен более чем на 50 жестовых языках и обеспечивает диктовку с жестов в Gboard и Live Transcribe на Pixel 11, начиная с американского жестового языка (ASL) и перевода на английский. Google называет это важным первым шагом для 70 миллионов человек в мире, которые пользуются жестовыми языками.
Второй пример — произношение. В Новой Зеландии Google работала с экспертами по языку маори, чтобы улучшить произношение топонимов в Google Maps: по логике автора, неправильно произнесённое название не просто путает, а затирает культурное наследие места. Культурно достоверные произношения встраиваются прямо в модели text-to-speech.
Что здесь отчёт, а что — заявление о намерениях
Масштаб в конце поста измеряется так: языковые технологии Google встроены в основные продукты, включая Search, Android, Chrome, YouTube и Google Play, и соединяют более пяти миллиардов человек на девяти платформах. Это утверждение об охвате, а не о качестве: цифр качества перевода по отдельным языкам в посте нет, как нет и сроков, когда TranslateGemma или SL2T выйдут за пределы описанных устройств и продуктов.
Практическая ценность материала — в карте направлений и в списке открытых данных: WAXAL, Project Vaani, LinguaMeta и Language Explorer доступны как публичные артефакты, а Universal Speech Model, cross-lingual transfer learning и Gemini 3.5 Live Translate показывают, где Google видит границу между транскриптом и пониманием речи. Тем, кому нужны измеренные метрики по конкретному языку, придётся искать их в отдельных публикациях и карточках моделей: сам пост устроен как обзор портфеля, а не как отчёт об измерениях.