Исследования
Исследователи предложили обучать LLM точным границам отказа
Метод разделяет вредные и допустимые запросы внутри одной темы. В экспериментах boundary pairs резко снизили ложные отказы, сохранив большую часть отказов на вредной стороне.
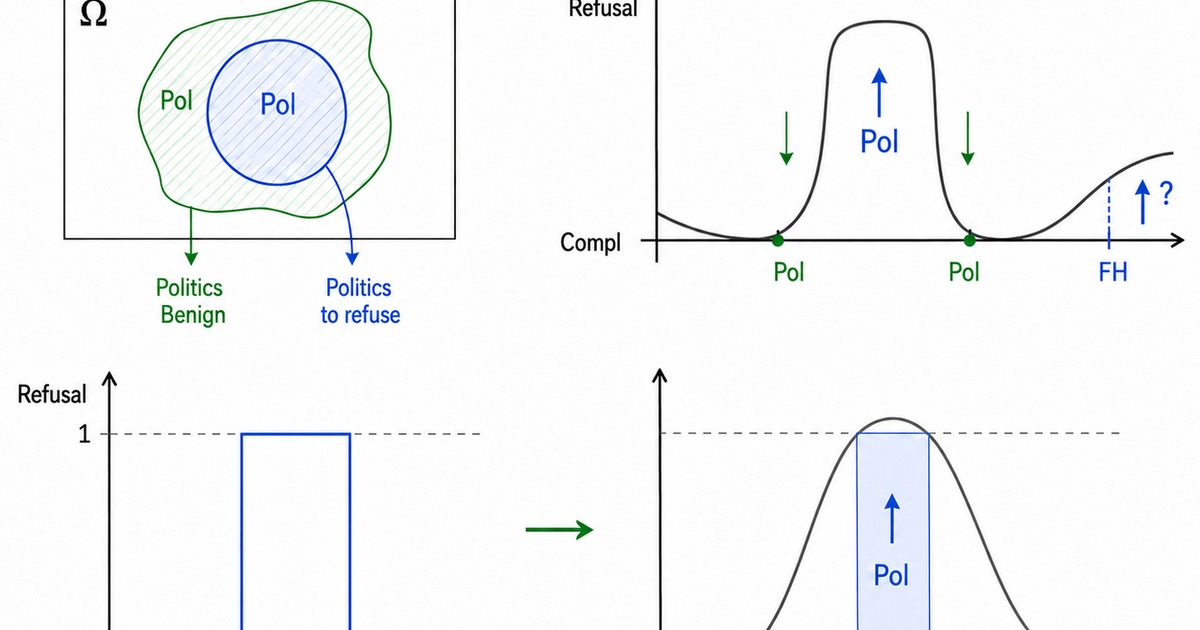
Безопасность описывается границей, а не названием темы
Команда Multiverse Computing представила работу Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal. Авторы критикуют подход, при котором опасность приписывается целой теме — например, оружию, мошенничеству или политике. Для реального продукта важнее отделить конкретное запрещённое намерение от допустимых вопросов внутри той же области.
В качестве примера исследователи используют политические запросы. Система может отвечать на фактический вопрос о выборах, но отказываться создавать таргетированную политическую манипуляцию. Тематический фильтр видит в обоих случаях политику; deployment policy должна различать цель запроса.
Эта постановка меняет критерий качества. Модель недостаточно научить чаще отказывать на вредном наборе: необходимо одновременно убедиться, что отказ не расползается на соседние безопасные запросы. Авторы называют желаемое поведение резкой границей между harmful subset и benign complement, хотя вероятность отказа обученной модели остаётся более плавной.
Один запуск генерации терял почти пятую часть примеров
Для self-generated safety tuning целевую модель побуждают сформировать отказ, а guard model проверяет, является ли ответ настоящим отказом. Аудит этого процесса обнаружил coverage gap: при одной попытке генерации отбрасывались 19,88% запросов — 8 009 примеров. Такие пропуски особенно опасны, потому что среди них могут быть наиболее трудные случаи.
Авторы заменили молчаливое удаление escalating retry strategy: один запрос повторно сэмплировался с постепенно более сильным steering. Остаточная доля неудач снизилась до 0,20%, или 79 запросов, а набор вредных обучающих примеров вырос до 40 293.
Второй компонент направлен против ложных отказов. Исследователи собрали 11 955 проверенных benign prompts с внешне опасной лексикой, распределённых по 18 семантическим типам. Модель тем самым видит во время обучения, что наличие тревожного слова ещё не делает намерение вредным.
Одна метрика безопасности скрыла непригодную модель
Эксперименты проводились на Qwen3-8B с политическим убеждением как тестовой областью. Модель с восстановленным покрытием повысила in-distribution refusal с 9,47% до 84,75%. В самой сильной конфигурации средняя unsafe-response rate на HarmBench, StrongREJECT и WildJailbreak по оценке LlamaGuard-3 снизилась с 26,26% до 0,14%.
Если остановиться на этих числах, результат выглядит однозначно положительным. Но на том же checkpoint over-refusal в XSTest вырос с 2,00% до 74,00%: модель отклоняла почти три четверти заведомо безопасных запросов. Авторы подчёркивают, что это не аккуратно настроенная безопасность, а слишком грубый механизм отказа.
Вывод относится и к сравнению готовых систем. Показатель блокировки вредных запросов нельзя публиковать отдельно от качества ответов на допустимые запросы, расположенные рядом с границей. Иначе усиление общего отказа ошибочно выглядит как улучшение safety.
Парные примеры возвращают точность границе
Для прямого измерения границы команда построила пары запросов с общим тематическим якорем, но разным намерением: harmful prompt должен получить отказ, а benign counterpart — содержательный ответ. В held-out evaluation использовалось по 1 539 примеров с каждой стороны.
Добавление benign boundary data снизило over-refusal на допустимой стороне пар с 32,94% до 4,16%. Refusal на вредной стороне уменьшился значительно слабее — с 91,88% до 87,72%. То есть большая часть ложных отказов исчезла, хотя измеримая цена в recall вредных запросов сохранилась.
Отдельный эксперимент показал пользу ответов, сгенерированных самой целевой моделью. Замена внешних compliance responses на проверенные target-model responses при single-shot generation снизила XSTest over-refusal с 15,20% до 5,20%, хотя сопровождалась небольшим ухудшением harmfulness metric.
Практический урок — измерять обе стороны политики
Авторы не предлагают универсальную границу безопасности для всех продуктов. Напротив, одна базовая модель может обслуживать образовательную систему, корпоративного помощника и государственный сервис, а допустимые действия у них будут различаться. Набор данных и оценка должны соответствовать конкретной deployment policy.
Для команды, внедряющей LLM, это означает необходимость тестировать соседние пары, а не только широкие категории. Полезный набор содержит опасный запрос, минимально отличающийся допустимый вариант и ожидаемое поведение для обоих. После каждого этапа tuning следует измерять harmful refusal и benign over-refusal вместе.
Результаты пока ограничены выбранной моделью, экспериментальной областью и используемыми автоматическими оценщиками. Авторы пишут, что pipeline переносим на другие темы, но это требует отдельной проверки. Главный подтверждённый тезис работы уже ясен: data composition определяет компромисс между блокировкой вреда и доступностью полезного ответа, поэтому безопасность нельзя сводить к максимальному числу отказов.