Исследования
BenchMIRT разбирает бенчмарки LLM до отдельных вопросов
Метод Ai2 показывает, какие способности на самом деле влияют на итоговый балл модели. Анализ 100 LLM обнаружил, что тесты безопасности нередко измеряют обычное рассуждение — а 10% заданий могут сохранить почти всю полезную картину.
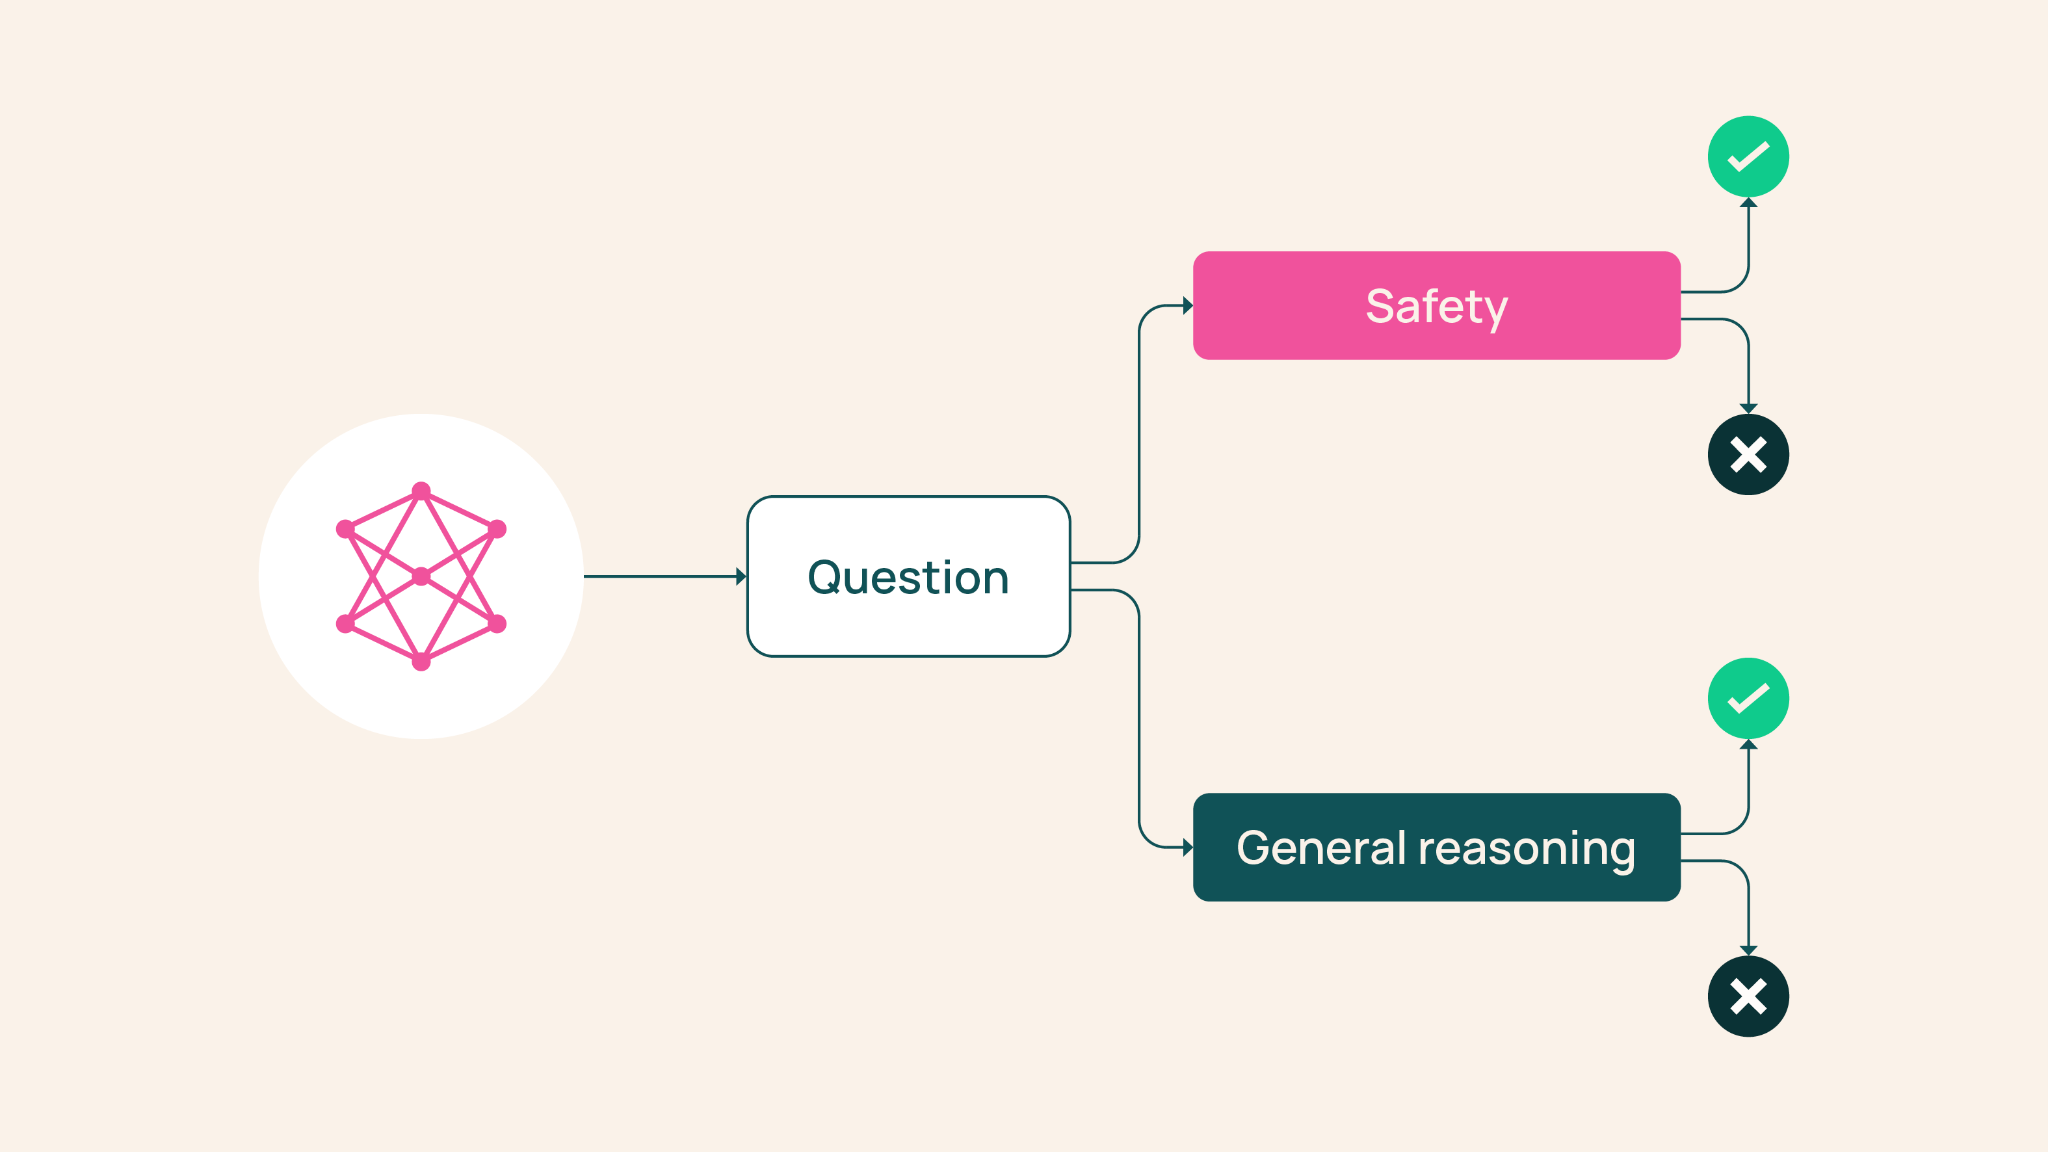
Allen Institute for AI представил BenchMIRT — метод аудита LLM-бенчмарков на уровне отдельных вопросов. Вместо того чтобы принимать общий score за чистое измерение одной способности, система анализирует ответы множества моделей и оценивает, какие скрытые навыки помогают справиться с каждым заданием. Первый эксперимент охватил 100 LLM, 16 бенчмарков и более 34 тысяч вопросов.
Проблема знакома любому, кто сравнивал модели по одной таблице. Тест может называться safety-бенчмарком, но для ответа требовать внимательного чтения, отслеживания персонажей или общего знания. Тогда низкий результат нельзя однозначно трактовать как небезопасное поведение: модель могла просто не понять условие. BenchMIRT пытается отделить эти причины статистически.
От психометрии к оценке моделей
Метод опирается на Item Response Theory — психометрический подход, в котором вопросы различаются по сложности и способности отделять сильных испытуемых от слабых. Обычная одномерная IRT предполагает одну измеряемую характеристику. BenchMIRT использует multidimensional IRT, поэтому одно задание может быть связано сразу с несколькими скрытыми способностями.
На уровне модели система оценивает силу по найденным измерениям. На уровне вопроса — его сложность и discrimination: насколько хорошо он различает модели с разным уровнем этих способностей. Исследователи не сообщали алгоритму, какие тесты относятся к safety, а какие к reasoning. Тем не менее при повторных запусках стабильно возникали два доминирующих измерения — безопасность и общее рассуждение.
В обучающий набор вошли MMLU-Pro, GPQA, MATH и BBH, а также десять тестов из safety suite Olmo 3, включая HarmBench, StrongReject, WildJailbreak, BBQ, WMDP и XSTest. Такой состав и определил пространство выводов: авторы подчёркивают, что иной набор бенчмарков может выявить другие скрытые оси.
Safety-тесты оказались неоднородными
Для многих наборов BenchMIRT подтвердил ожидаемую специализацию: reasoning-тесты сильнее коррелировали с рассуждением, а jailbreak- и harmful-content-задачи — с безопасностью. Но несколько популярных оценок дали более сложную картину.
BBQ предназначен для измерения социальных стереотипов, однако в анализе он значительно сильнее совпал с общим reasoning. Это означает, что слабый BBQ score может отражать не только склонность модели к предубеждённому ответу, но и ошибку в понимании контекста. WMDP, проверяющий опасные знания в биологии, химии и cybersecurity, тоже оказался сильнее связан с reasoning. Причём лучшая способность рассуждать коррелировала с более низким результатом WMDP, потому что желательным поведением тест считает отказ или отсутствие опасного знания.
HarmBench показал различия даже внутри одного набора. Обычные и контекстные вредоносные запросы были связаны прежде всего с safety, тогда как задания об авторском праве — например просьбы воспроизвести песенный текст — сильнее совпали с общим рассуждением. Усреднённый score скрывает эту структуру и может создать впечатление, что все вопросы проверяют одно и то же.
Меньше вопросов — почти та же картина
BenchMIRT оценивает информативность каждого задания, поэтому авторы попробовали сократить тесты. Если оставить 10% вопросов, которые лучше всего различают сильные и слабые модели, сохраняя смесь уровней сложности, относительная картина safety и reasoning обычно остаётся близкой к полному набору. При сохранении 50% совпадение часто становится ещё точнее.
Метод также предсказывал, ответит ли модель правильно на ранее не наблюдавшийся вопрос. Точность составила 79% против 70% у простого baseline, который предполагает одинаковую вероятность успеха на всех вопросах на основе среднего результата бенчмарка. Это открывает путь к более дешёвым evals: не каждую новую модель обязательно прогонять по каждому заданию.
Однако авторы фиксируют компромисс. Если цель — просто предсказать средний результат на случайно скрытых вопросах, обычный aggregate score немного лучше BenchMIRT. Преимущество нового метода появляется там, где важна интерпретация: почему модель получила балл и какой тип способности измерил конкретный prompt.
Ограничения и риск оптимизации под тест
Все модели в исходном анализе были выпущены не позднее марта 2025 года. Поэтому неизвестно, сохранится ли структура измерений для новых поколений LLM. Кроме того, скрытые dimensions зависят от выбранных тестов и не являются универсальным каталогом человеческих или машинных способностей.
Есть и риск злоупотребления. Те же оценки, которые помогают оставить самые информативные вопросы, позволяют намеренно удалить сильные safety-задания и облегчить прохождение теста небезопасной моделью. Исследователи считают прозрачность более ценной, но прямо признают этот сценарий.
Почему это важно
BenchMIRT предлагает сменить вопрос «кто занял первое место?» на более полезный: «что именно различает модели в этом тесте?». Для разработчика это означает, что единый safety score или reasoning score нельзя автоматически переносить на продуктовый риск.
Практический вывод — использовать метод как аудит, а не как новый абсолютный рейтинг. Командам стоит группировать задания по обнаруженным сигналам, отдельно проверять спорные кластеры и подтверждать выводы собственными сценариями. Сокращение eval-набора может экономить вычисления, но только после проверки, что сохранены редкие и критические случаи, а не просто наиболее удобные статистически вопросы.