Исследования
«Тот же агентский харнесс, что используется в продакшене, напрямую участвует в обучении с подкреплением»: Microsoft Research выпустила Agent Lightning v1.0 — 3500 строк для agentic RL
7 октября 2026 года Microsoft Research Asia представила Agent Lightning v1.0 — переписанную с нуля открытую систему обучения агентов с подкреплением примерно в 3500 строк кода. Фреймворк реализует парадигму Harnessed Agentic RL: в обучении участвует тот же агентский харнесс, что идёт в продакшен. В экспериментах сквозной конвейер на Qwen3.5-9B поднял Pass@1 на SWE-bench Verified с 41,8% до 56,4% — на 14,6 процентного пункта — при примерно 6000 обучающих примерах.
Что предложила Microsoft Research Asia
Agent Lightning v1.0 — переписанная с нуля открытая система обучения AI-агентов с подкреплением примерно в 3500 строк кода. Свою парадигму авторы называют Harnessed Agentic RL: в обучении напрямую участвует тот же агентский харнесс, который затем используется в продакшене.
Классическая схема agentic RL предполагает, что цикл взаимодействия со средой принадлежит обучающему фреймворку: модель выдаёт действие, среда возвращает наблюдение, наблюдение добавляется в контекст — и весь роллаут укладывается в одну непрерывную траекторию токенов. Так были устроены ранние системы вроде verl, AReaL и slime, и обучение агента требовало пересборки его цикла внутри RL-фреймворка.
Реальные харнессы из этой предпосылки выросли: кодовые агенты mini-SWE-agent, OpenHands, OpenCode, Claude Code и Codex приносят с собой собственное управление контекстом, протоколы инструментов, логику исполнения и зависимости. Пересобирать такой харнесс дорого, а собранная заново версия может вести себя иначе, чем развёрнутая. Решение — поставить LLM-прокси между агентом и моделью: достаточно направить на Agent Lightning тот endpoint, который раньше вызывал API модели, а обучающий фреймворк будет наблюдать и записывать её вызовы.
Четыре задачи обучения на реальных харнессах
Раз цикл взаимодействия со средой ведёт харнесс, а не тренер, обучающая система видит только последовательность пар «запрос — ответ» к модели, и один роллаут может распадаться на переменное число обучающих примеров. Отсюда четыре ключевые проблемы.
Первая — верность token ID: харнессы хранят контекст текстом, а RL-обучению нужны идентификаторы токенов, сэмплированных во время роллаута, и повторный проход через chat-шаблон и токенизатор может сдвинуть границы токенов, так что соседние вызовы не всегда удаётся слить в один пример. Вторая — расчёт преимущества: ретокенизация, субагенты и суммаризация контекста дробят роллаут на несколько примеров, и покомпонентный расчёт базовых линий заставляет роллауты с большим числом примеров считаться повторно, меняя исходные статистические соотношения на уровне роллаута.
Третья — нормализация лосса: усреднение по числу примеров даёт больший вес роллаутам, которые породили больше примеров, хотя это лишь продукт поведения харнесса. Четвёртая — переменная нагрузка против фиксированных ресурсов: число и длина примеров известны только после завершения харнесса, а конфигурации параллелизма и число GPU обычно зафиксированы заранее, поэтому бэкенду приходится укладывать переменную нагрузку в постоянные ресурсы.
Как устроена система в 3500 строк
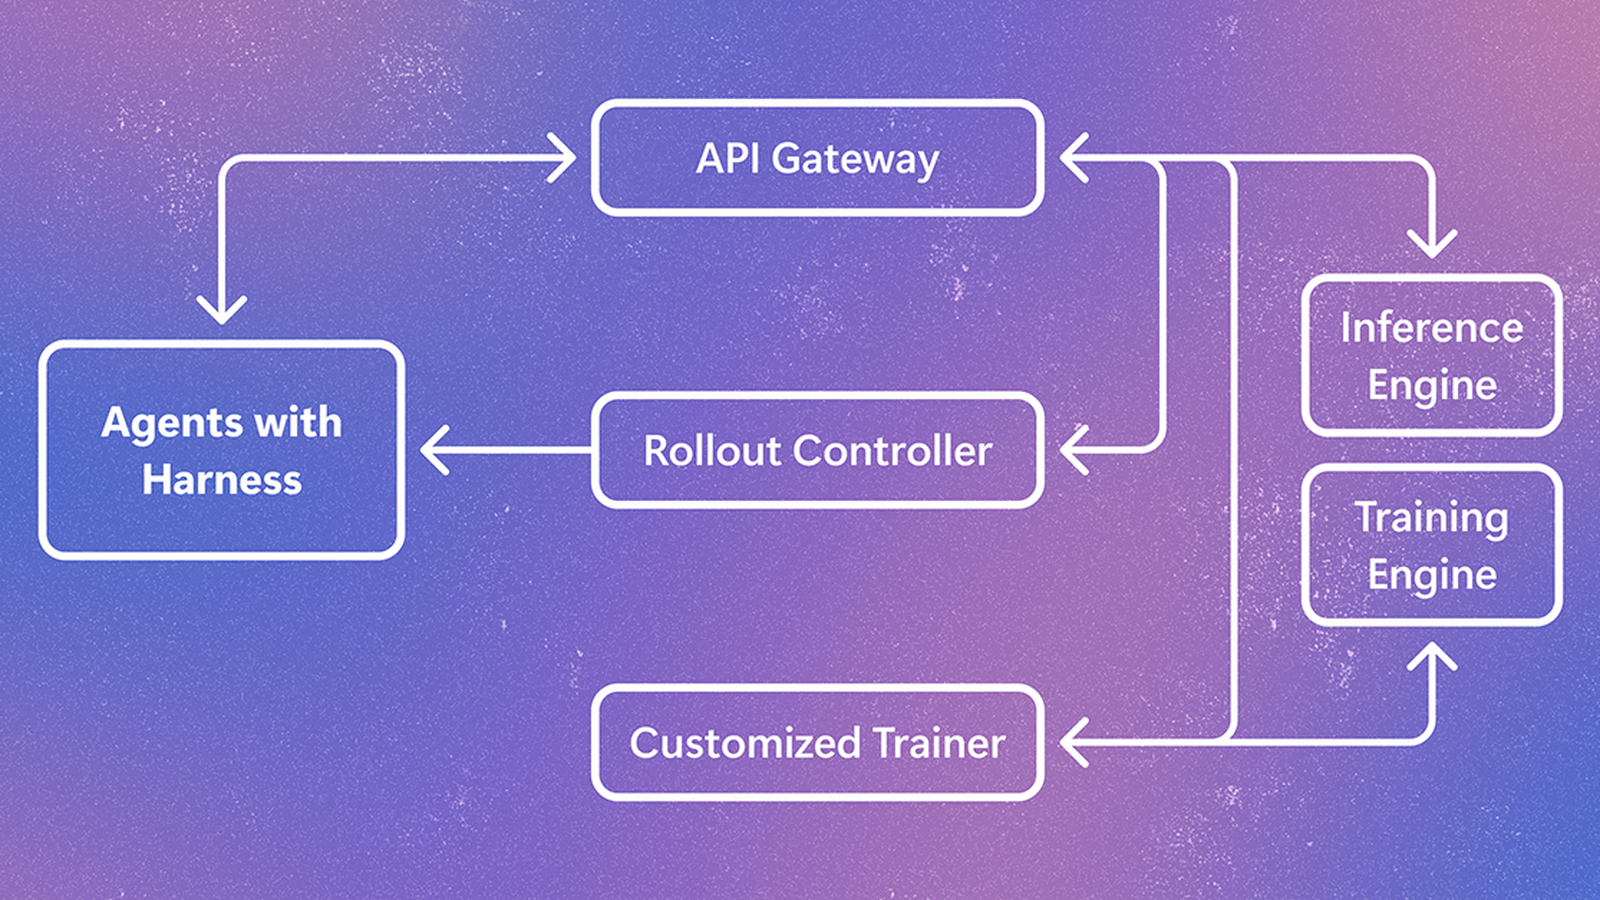
В v1.0 три ключевых компонента: API Gateway, Rollout Controller и Customized Trainer. Шлюз хранит роллауты, модели и события и работает как OpenAI-совместимый LLM-прокси: он связывает каждый вызов модели из харнесса с его роллаутом и записывает промпты, ответы и логвероятности, необходимые для обучения.
Rollout Controller запускает и ведёт исполнение агентов — либо как локальные процессы, либо как обычные задания Kubernetes, — удерживая исполнение агента отдельно от тренера. Обучающая часть построена на verl: она создаёт роллауты, дожидается их завершения, собирает сэмплы и через sample adapter формирует итоговые обучающие примеры.
Для разброса времени роллаутов в v1.0 ввели Collocated Async RL: роллауты и обновление модели делят один и тот же набор GPU. Когда роллаутов набрано достаточно, шлюз перестаёт принимать новые запросы и ждёт завершения уже идущих, а после обновления роллауты возобновляются — для внешнего харнесса переход прозрачен. В экспериментах это дало примерно двукратное ускорение сквозного времени по сравнению с синхронным RL при меньшем числе GPU, чем у обычного асинхронного.
6000 примеров и +14,6 пункта
Сквозной конвейер кодового агента построили на SWE-smith, mini-SWE-agent и Qwen3.5-9B, закрыв очистку данных, построение окружений, защиту от reward hacking и само обучение с подкреплением. Обучающий набор — примерно 6000 примеров, и крупных вычислительных затрат он не требует.
Само RL-обучение подняло Qwen3.5-9B на SWE-bench Verified с 41,8% до 56,4% Pass@1, то есть на 14,6 процентного пункта. Расчёт преимущества на уровне роллаута вместе с нормализацией на уровне роллаута дал более высокую награду на валидации и более стабильную энтропию политики, чем покомпонентная обработка.
Отказ от платных песочниц авторы называют отдельным принципом: другие фреймворки Harnessed Agentic RL нередко размещают агентов на коммерческих sandbox-сервисах вроде Modal Sandbox или E2B, где стоимость быстро растёт с масштабом, а v1.0 запускает их как стандартные задания Kubernetes — на уже имеющихся кластерах, в облачном Kubernetes или на локальной инфраструктуре.
Рамка
Работу ведёт группа MSRA (Shanghai) System and Engineering Group в Microsoft Research Asia; пост в блоге подписала Бренда Поттс (Brenda Potts). Переписанная версия фреймворка открыта в репозитории microsoft/agent-lightning.
Акценты, которые авторы выносят в заголовок, — компактность, интеграция с настоящими харнессами и воспроизводимый сквозной конвейер: кодовая база описана как достаточно небольшая, чтобы её можно было целиком прочитать, изменить и расширить, а обучение — как воспроизводимое на открытых данных.