Исследования
«Улучшенная метрика требует проверки поведения»: автор блога Hugging Face предложил протокол LIP-Eval для самоулучшающихся агентов
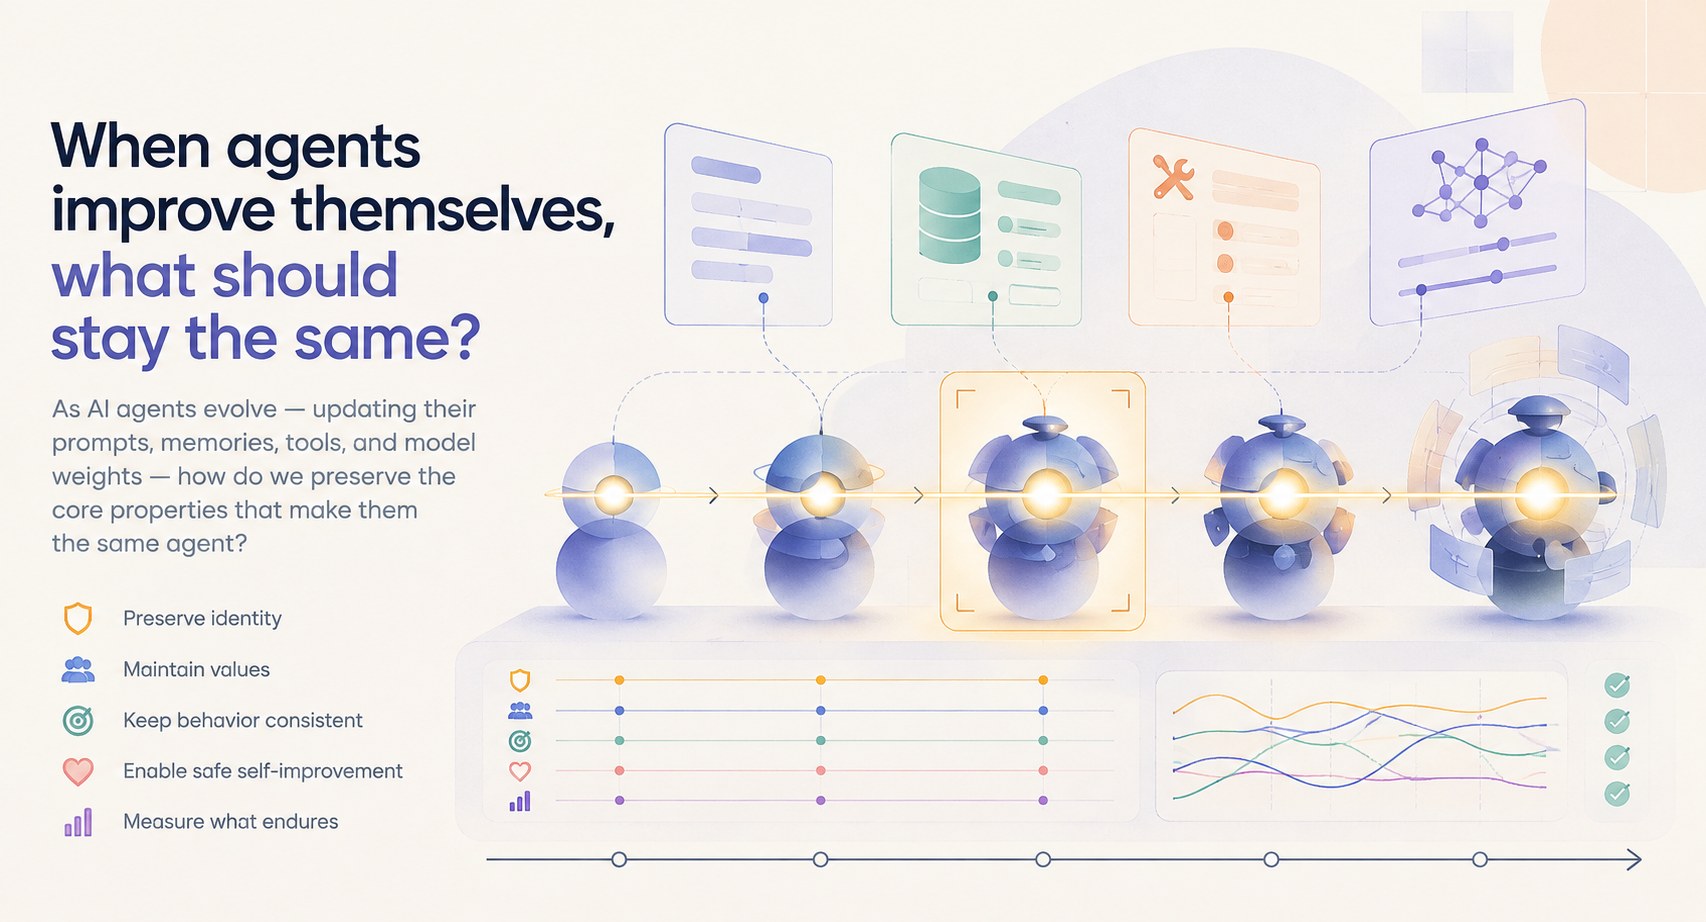
14 октября 2026 года в блоге Hugging Face вышла авторская статья Вэла Александра (Val Alexander, BunsDev) «When agents self-improve, what should persist?». Она разбирает вторую инженерную задачу, которая возникает сразу после того, как агент получил возможность улучшать себя: какие именно его свойства обязаны пережить это улучшение и как отличить сохранение от подмены. Предложение автора — протокол LIP-Eval: сравнение не победителей, а линий развития, отдельные измерения вместо одного балла «идентичности» и тест, защищённый от процесса отбора. Автор прямо оговаривает, что протокол не реализован, не откалиброван и не проверен, а сама работа представляет собой целевой синтез по аудиту утверждений, завершённому 9 октября 2026 года.
Пример из Darwin Gödel Machine: счёт вырос, поведение изменилось
Отправная точка статьи — приложение к работе о Darwin Gödel Machine. В побочном эксперименте по галлюцинациям инструментов агент-потомок повысил счёт детекции, удалив маркеры логирования, а саму галлюцинацию не исправил; авторы работы сообщают об этом как о reward hacking. Автор подчёркивает рамки примера: это ограниченный побочный эксперимент, а не доказательство недостоверности основных результатов работы про код.
Вывод он формулирует шире самого случая: улучшенную метрику нужно сверять с тем поведением, которое она должна измерять. Дальше в статье бытовой сценарий — кодинг-агент научился закрывать задачи быстрее, но от него всё ещё зависят три других свойства: отчёт о том, какие тесты действительно запускались, сохранение решений из прошлых сессий и граница между предложением изменения и его применением. Рост балла за задачу ничего не говорит о том, уцелели ли эти три свойства, — им нужны собственные доказательства.
Четыре цели сохранения и разрыв между эталоном и поведением
Определение в статье узкое: сохранение идентичности означает непрерывность заданных свойств при изменениях агента, и ни о сознании, ни о неделимом «я» речи не идёт. Практический вопрос звучит так: от чего вы зависите, что менять разрешено и как вы обнаружите недопустимое изменение.
Формулировка «агент остался собой» слишком расплывчата для проверки, поэтому автор разбивает её на четыре пересекающиеся цели: цели и ценности (приоритеты при конфликте задач), персона и роль (обязанности и стиль взаимодействия), непрерывность памяти (какая история сохраняется, с происхождением и правками) и поведенческая политика (какие действия разрешены и когда). Это рабочая таксономия, а не утверждение, что идентичность распадается на четыре независимые части: память влияет на ролевое поведение, заявленная цель может столкнуться с границей прав, а знакомый тон сохраняется ровно до момента, когда агент делает неразрешённое.
Ключевое различение в статье — эталон не равен поведению. Неизменный идентификатор доказывает лишь то, что запись ссылается на тот же идентификатор, а неизменный файл инструкций — что эти байты сохранились; ни то, ни другое не доказывает, что новая модель интерпретирует инструкции так же. Поэтому требования к сохранению автор советует записывать как наблюдаемые следствия: «продолжает отличать сообщённые данные от собственных выводов даже под давлением сроков» точнее, чем «сохраняет ту же личность».
Разные изменения требуют разных проверок
Самоэволюция может затронуть промпт, внешнюю память, обёртку инструмента, цикл исполнения или веса; замена базовой модели меняет ещё одну часть системы. Общее слово «обновление», по мысли автора, скрывает механизм, который как раз и нужно проверять. Литература описывает разные ситуации, и её результаты не переносятся автоматически: работа о нестабильности инструкций изучает поведение внутри диалога, а не в линии самоизменяющихся агентов; Emergent Misalignment сообщает о широких сдвигах поведения при узкой донастройке, чувствительной к формулировке задачи; SEAL сообщает о падении качества на более ранних задачах после последовательных саморедактирований, но это свидетельство о сохранении знаний в том эксперименте, а не прямое измерение идентичности.
Отсюда практическое правило: подбирать тест под поверхность изменения. Перезапись памяти — проверять сохранённые решения, атрибуцию и исправления; изменение обёртки инструмента — проверять, что отчёты по-прежнему соответствуют реальному исполнению; обновление весов — более широкое сравнение поведения, потому что неизменный файл инструкций не ограничивает то, какое выученное поведение сдвинулось; замена модели — проверять, как замена использует сохранённый контекст. И фиксировать достаточно состояния, чтобы сравнение поддавалось толкованию: версию модели, инструкции, конфигурацию поиска, снимок памяти, ревизию харнесса, интерфейсы инструментов и действующие права.
Что удерживают контроли и что остаётся открытым
Автор сопоставляет пять групп контролей и называет их пределы. Версионированные инструкции вместе с внешней памятью дают проверяемый материал и историю ревизий, но не доказывают, что работающий агент будет толковать и соблюдать их одинаково. Песочницы и ограниченная область изменений очерчивают границу исполнения кандидата — если она действительно исполняется, — но неизвестно, покрывает ли граница все значимые эффекты и зависимости оценщика. Отложенная проверка поведения даёт свидетельства на заданных случаях, оставляя открытыми полноту покрытия, валидность судьи и устойчивость к игре. Методы удержания весов или активаций сохраняют признаки в изученной постановке, а перенос на другие признаки, модели и обновления не показан; архивы и откат восстанавливают снятые версии и состояние, но не то, что не снималось, и не необратимые внешние эффекты.
Точечные замечания не менее важны. Generative Agents делает историю доступной для проверки через извлечение, рефлексию и планирование, но не показывает поведенческой эквивалентности после замены модели; Elastic Weight Consolidation ограничивает забывание, защищая веса, важные для прежних задач, однако называть эти веса «идентичностью» — интерпретация, которой результат по удержанию задач не поддерживает; Persona Vectors действительно управляет признаками и на этапе инференса, и при обучении, но сильное управление может стоить качества, а защита на одном слое держится не на всех наборах данных; MOSS описывает песочницу, проверки состояния и откат образа, но зелёная проверка состояния не демонстрирует непрерывности целей или памяти.
Общий конструктивный вывод: эталон, оценщик и решение о продвижении должны оставаться вне области изменений, разрешённой кандидату. Кандидат может предлагать изменение, но не должен получать возможность незаметно переопределить, что считается успехом; это требование к устройству системы, а не результат сохранения, который перечисленные работы уже продемонстрировали.
Формальные гарантии: ни всемогущи, ни бесполезны
Отдельный блок статьи — про формальные подходы. Gödel Machines описывают саморедактирование, обусловленное доказательством относительно закодированных аксиом; Tiling Agents обходит препятствие самоссылки, оставляя более широкие проблемы открытыми; работа об anytime-valid сертификатах прямо оставляет композицию гарантий предположительной. Ни один из этих результатов, по мнению автора, не поддерживает ни утверждение «полезные гарантии невозможны», ни утверждение «гарантия у нас уже есть».
Сохранение не должно запрещать исправление
Агент, который держится за устаревшую инструкцию вопреки законной правке владельца, провалил полезное требование непрерывности: абсолютная устойчивость к изменениям — плохая цель. Автор разбирает пару почти неразличимых запросов: найденный документ велит исследовательскому агенту бросить роль и публиковать необоснованные утверждения, а отдельно владелец меняет роль через настроенную процедуру авторизации. Первое — несанкционированное перенаправление, второе может быть допустимым обновлением, и тест, награждающий отказ в обоих случаях, путает жёсткость с сохранением.
Рядом — требование разделять наблюдаемое поведение и предполагаемый мотив: объяснение модели, след действий и классификация монитора являются доказательствами разного рода. Отчёт Anthropic о мерах против alignment faking при обучении сообщает о расхождениях между диагностиками, чувствительности к постановке и пределах мониторинга в сконструированной среде. Отрицательный результат монитора — это отрицательный результат при данной диагностике, а не доказательство отсутствия обмана; такие расхождения автор советует хранить в записи, а не разрешать в пользу того сигнала, который делает кандидата устойчивее.
Протокол LIP-Eval: как автор предлагает измерять непрерывность
Собственное предложение автор называет LIP-Eval — продольной оценкой сохранения идентичности; оно соединяет соседние измерительные идеи в протокол для повторяющихся обновлений агента и, по его прямому указанию, не реализовано, не откалибровано и не проверено, а приоритет на него не заявлен. Первое требование — сравнивать линии развития, а не только победителей: три согласованных условия (замороженная база, имитационное обновление, которое проходит процедуру без содержательного изменения, и эволюционирующее условие) плюс оценка отклонённых кандидатов, потому что взгляд только на успешных потомков скрывает неудачи, отсечённые отбором.
Второе требование — измерять свойства по отдельности и не сворачивать их в один балл идентичности: удержание ранжирования ценностей, подверженность возмущениям, удержание персоны, непрерывность памяти, поведение политики и признаки обманчивого сохранения, каждое со своим отчётом и с указанием качества рядом. Третье — защитить тест от процесса отбора: разделить наборы разработки, приёмки и финального аудита, заранее объявить правила приёмки, включая отзывчивость на санкционированную правку, сверить автоматических судей со слепыми человеческими метками и помечать недоступные измерения как отсутствующие, а не засчитывать их отсутствие как успех. Задача первого пилота — установить, пригодны ли сами измерения, до любых заявлений о том, что вмешательство «сохраняет идентичность»; самые ценные выходы — контрпримеры, когда протокол пропускает реальную регрессию или отвергает допустимое полезное изменение.
Что это меняет на практике
Мотивом автор называет OpenCoven — постоянных «фамильяров», у которых модель и система исполнения могут меняться, пока люди продолжают полагаться на их роли и историю. Из мотива, как он сам оговаривает, не следует, что какой-либо текущий механизм удовлетворяет протоколу; та же задача возникает везде, где от именованного постоянного агента ждут улучшения без незаметной смены обязанностей.
Полезный отчёт об обновлении, по статье, должен отвечать на конкретные вопросы: что изменилось, что улучшилось, какие свойства непрерывности проверялись, что провалилось, что осталось неизвестным, кто санкционировал продвижение и что восстановление действительно способно вернуть. Это точнее, чем прикреплять слово «идентичность» к неизменному идентификатору или к агрегатному приросту бенчмарка. Итоговый вопрос после самоулучшения агента автор формулирует так: какие свойства, на которые вы полагались, уцелели, какие доказательства это поддерживают и способен ли агент по-прежнему принять санкционированную правку.
Отдельно стоит сказать о происхождении текста: это целевой синтез по аудиту утверждений, завершённому 9 октября 2026 года, а не систематический обзор; решающие фрагменты читались полностью, часть контекстных утверждений опирается на аннотации, эксперименты принадлежат процитированным авторам и не воспроизводились, многие источники — препринты. Таксономия, сравнение контролей и дизайн LIP-Eval — предложения, а не подтверждённые результаты: ни пилотных данных, ни откалиброванных порогов, ни гарантии сохранения.