Бизнес
«Продуктивные, надёжные, взаимозаменяемые»: NVIDIA объяснила, чем окупаются AI-фабрики
AI-фабрики строят мегаваттами, и каждый мегаватт стоит около $60 млн — такие деньги вкладывают только под ясную отдачу. NVIDIA 1 октября 2026 года разложила эту отдачу на три фактора: выработку, срок полезной службы и спрос на токены, — и назвала свой ответ на них: продуктивность, долговечность и взаимозаменяемость.
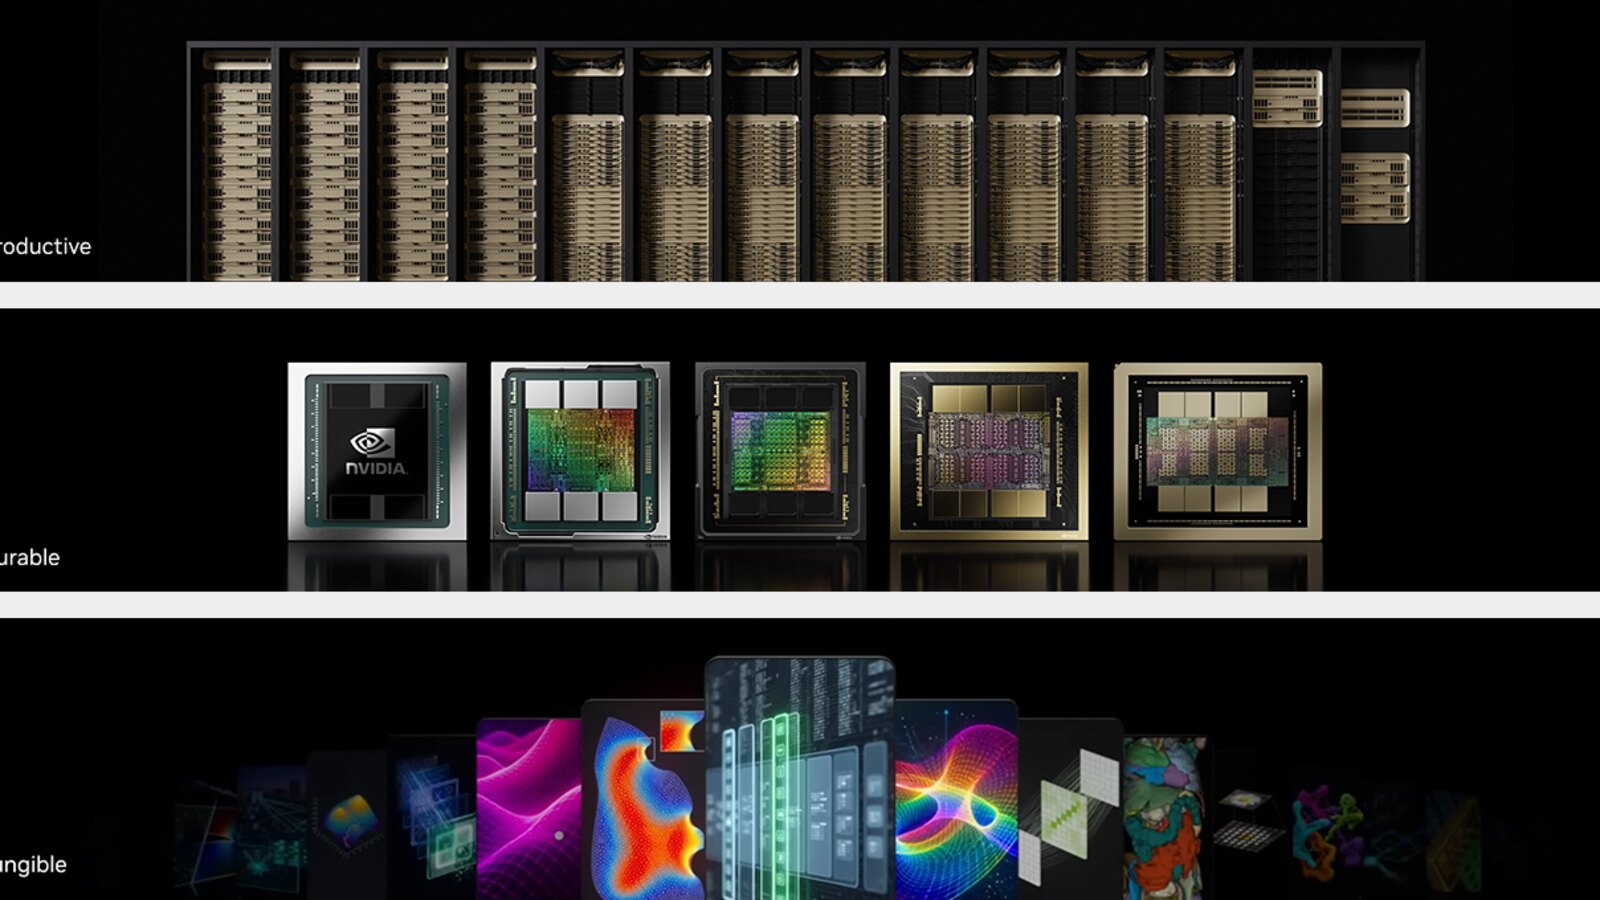
Экономика на мегаватт
AI-фабрики строят мегаваттами, а в пределе и гигаваттами: каждый мегаватт такой фабрики стоит примерно $60 млн, и операторы готовы вкладывать капитал такого масштаба только при ясном взгляде на возврат инвестиций.
Отдачу формируют три вещи: выработка (сколько фабрика могла бы заработать за год, если бы продала каждый произведённый токен), срок полезной службы (как долго её железо продолжает зарабатывать) и спрос (насколько он велик на эти токены).
NVIDIA отдельно оговаривает, что сильная сторона не компенсирует слабую: высокая выработка мало значит, если продаётся лишь часть произведённого, а высокий спрос мало значит, если через год фабрика перестаёт работать на полную мощность. Три фактора не независимы: фабрика, которая умеет больше типов задач, находит больше спроса и продолжает зарабатывать год за годом.
Продуктивность: токены на мегаватт
Энергия — ограничивающий ресурс AI-фабрики, поэтому ключевой метрикой выработки становятся токены в секунду на мегаватт: больше токенов внутри фиксированного энергетического конверта — больше выручки, а ниже стоимость токена — выше маржа с него.
По данным анализа SemiAnalysis AgentX, системы NVIDIA Vera Rubin NVL72 дают более чем 30-кратную пропускную способность на мегаватт по сравнению с NVIDIA GB300 NVL72 и до 45-кратно меньшую стоимость за миллион токенов на модели DeepSeek V4 Pro. NVIDIA объясняет разрывы такого размера сквозным кодизайном всего стека — от моделей и нагрузок через программное обеспечение к вычислениям, сетям и памяти, оптимизированным вместе.
Отсюда два вопроса, которые NVIDIA ставит сама. Делает ли удешевление токенов спрос на вычисления меньше? Нет, он расширяется: более дешёвые токены делают экономически осмысленными новые сценарии, и эти сценарии потребляют больше токенов, чем экономит эффективность.
Долговечность: установленный парк продолжает зарабатывать
Второй вопрос — что происходит со старшими поколениями, если каждое новое настолько лучше предыдущего. Ответ NVIDIA: не каждой нагрузке нужна новейшая система, правильный выбор зависит от сложности и формы нагрузки, поэтому предыдущее поколение продолжает зарабатывать и после выхода следующего.
NVIDIA A100 вышла в 2020 году и спустя шесть лет всё ещё находится в коммерческой эксплуатации, а CoreWeave недавно продлила бронирования на блоки, впервые представленные в 2020 году, до 2029 года. Крупные операторы годами продлевали срок амортизации серверов — это по сути ставка на то, когда железо перестанет зарабатывать, и она продолжает сдвигаться вправо. Сентябрьский анализ Sprout «The Productive Life of a Data Center GPU» (2026) отслеживает, как этот график смещался у каждого крупного оператора; там же важная оговорка — учётный срок службы является консервативным приближением физического, и парк NVIDIA V100 у Microsoft отработал 8,4 года против шестилетнего книжного срока.
Три независимых ориентира по цене перепродажи и аренды приводятся в самой публикации: Barkr оценивает полезный срок в пять-шесть лет для системы из восьми GPU H100 и в девять-десять лет для GB300 NVL72, Silicon Data показывает, что шестилетний A100 всё ещё стоит четверть своей исходной цены — тогда как пятилетний график амортизации обнулил бы его больше года назад, а Ornn Data фиксирует, что рынок платит 80% от цены месячной аренды A100 при аренде на пять лет.
Технологическая основа долговечности, по версии NVIDIA, — CUDA: платформа программирования GPU работает через поколения, поэтому уже купленное железо не оказывается брошенным при выходе новой архитектуры, а непрерывная оптимизация программного обеспечения и ядер продолжает улучшать то, что уже установлено. На той же платформе работают машинное обучение, глубокое обучение, генеративный ИИ, reasoning, агентный и физический ИИ — каждый новый тип работы приходил на железо, которое к тому моменту уже стояло.
Взаимозаменяемость: любой ИИ, любая фаза, любое место
NVIDIA формулирует это так: фабрика, построенная под один тип работы, — это ставка на то, что работа не изменится, а фабрика, которая умеет всё, остаётся полезной и доходной даже тогда, когда работа меняется.
AI-фабрики NVIDIA заявлены как способные запускать любой тип моделей — открытых и проприетарных — в языках, зрении, биологии, физике и робототехнике, на всех фазах от обработки данных через претрейн и посттрейн к инференсу, и во всех местах: от гиперскейла и AI-облаков до суверенных программ, корпоративных центров обработки данных и периферии.
При этом не всё сводится к построению и запуску моделей: та же инфраструктура считает данные, научные вычисления, симуляции и графику. Все эти нагрузки, ИИ и не-ИИ, сводятся к одному и тому же параллельному счёту, который GPU NVIDIA выполняют на тысячах ядер одновременно; CUDA — причина, по которой один чип может и свет симулировать, и белок сворачивать, и предсказывать следующий токен, а сверху лежат более 1 000 готовых библиотек CUDA-X и более 10 млн разработчиков.
Именно это, по мысли NVIDIA, делает её GPU универсальной ускоряемой вычислительной платформой, а не заказным ASIC под одну нагрузку; универсальность при этом не означает обезличенность — Tensor Cores и Transformer Engine встраивают оптимизированное под ИИ железо внутрь программируемой архитектуры.
Как это выглядит в продакшене
Публикация перечисляет примеры из практики заказчиков: Lilly строит и запускает модели белков, малых молекул и геномики на локальном кластере из 1 016 GPU, а также чат-боты и агентные сценарии для собственных команд; Pinterest проводит посттрейн и развёртывает vision-language-модель в гиперскейл-облаке на 14 000 GPU, охватывающих NVIDIA Blackwell, Hopper и более ранние архитектуры.
Revolut обрабатывает данные миллиардов транзакций с помощью NVIDIA cuDF, а затем обучает и развёртывает foundation-модель в AI-облаке; Runway обучает world model на NVIDIA Hopper и обслуживает его на платформе NVIDIA Blackwell в облачной инфраструктуре; Texas A&M University ведёт молекулярное моделирование и AI-поиск лекарств на своём суперкомпьютере с загрузкой 95-98% на 26 проектах и семи институциях.
За пределами ИИ Dassault Systèmes питает симуляцию виртуального двойника для сертификации самолётов в Wichita State и проектирования автомобилей в Lucid Motors, а Unilever строит изображения продуктов из цифровых двойников вместо фотосессий, сокращая производственные затраты вдвое.
Что дальше
Итоговая формула NVIDIA звучит так: более выгодные токены, более долгий срок службы и более глубокий спрос — именно это максимизирует возврат на AI-фабрику.
Основатель и CEO NVIDIA Дженсен Хуанг выступит с ключевым докладом GTC Berlin в среду 21 октября в 11:00 по центральноевропейскому летнему времени; сама конференция проходит 20-22 октября.